[Curious] Head Avatar scratch
ELITE 논문 기반으로 간단한 Head Avatar를 구현한다.
목차
들어가며
motivation 자체는 최근의 여러 3D Head Avatar 논문을 보다가 공통적으로 발견한 부분으로 Canonical UV Map을 통해 Appeaance를 High-Quality로 표현하는 부분들이 보였다.
ELITE (CVPR 2026), FiCA (Meta Tech Report 2026)
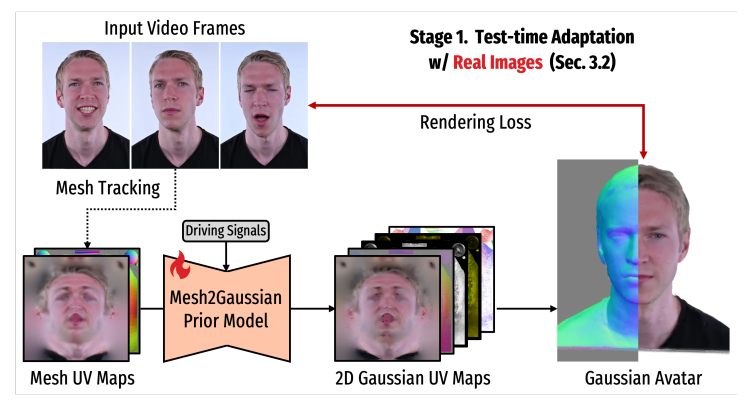
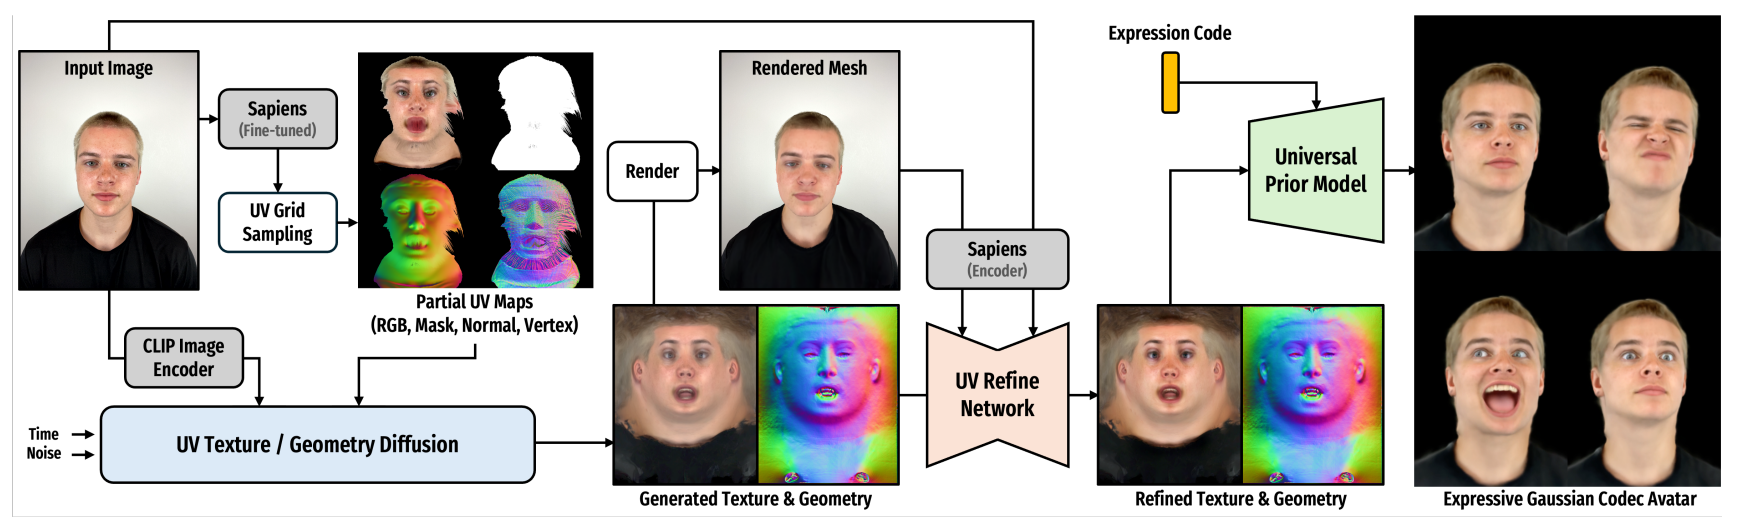
기존에 3D Head Avatar를 표현하는 대표적인 방법으로 GaussianAvatars (CVPR 2024 Highlight) 논문과 같이 FLAME Mesh 기반에서 gaussian을 initial하면서 rigging하며 기존 3DGS 방식처럼 update하는 방법이 가장 익숙하다.
결론적으로 이번 Head Avatar scratch를 통해서 UV Map을 이용한 3D Head Avatar Reconstruction에 한 단계씩 알아보는 것을 목표로 한다. 특히 Canonical UV Map -> Gaussian UV Map -> Gaussian Avatar라는 이 흐름 자체를 이해할 수 있으면 나중에 요긴하게 사용할 수 있을 것 같다. 동시에 UV Map 사용의 기존 방법론 보다 어떤 장점을 가지고 있는지에 대해서도 살펴보면 좋을 것 같다.
1. Video → Tracking (FLAME) (1, 2, 3)
먼저 Input Video로부터 FLAME Mesh를 얻기 위한 초반 과정이 필요하다. 아주 정확하진 않지만, 하나씩 순서대로 생각나는 것을 적어보자면
1단계 (ffmpeg, matting)
Video → Frame분리 → Alpha값 추출
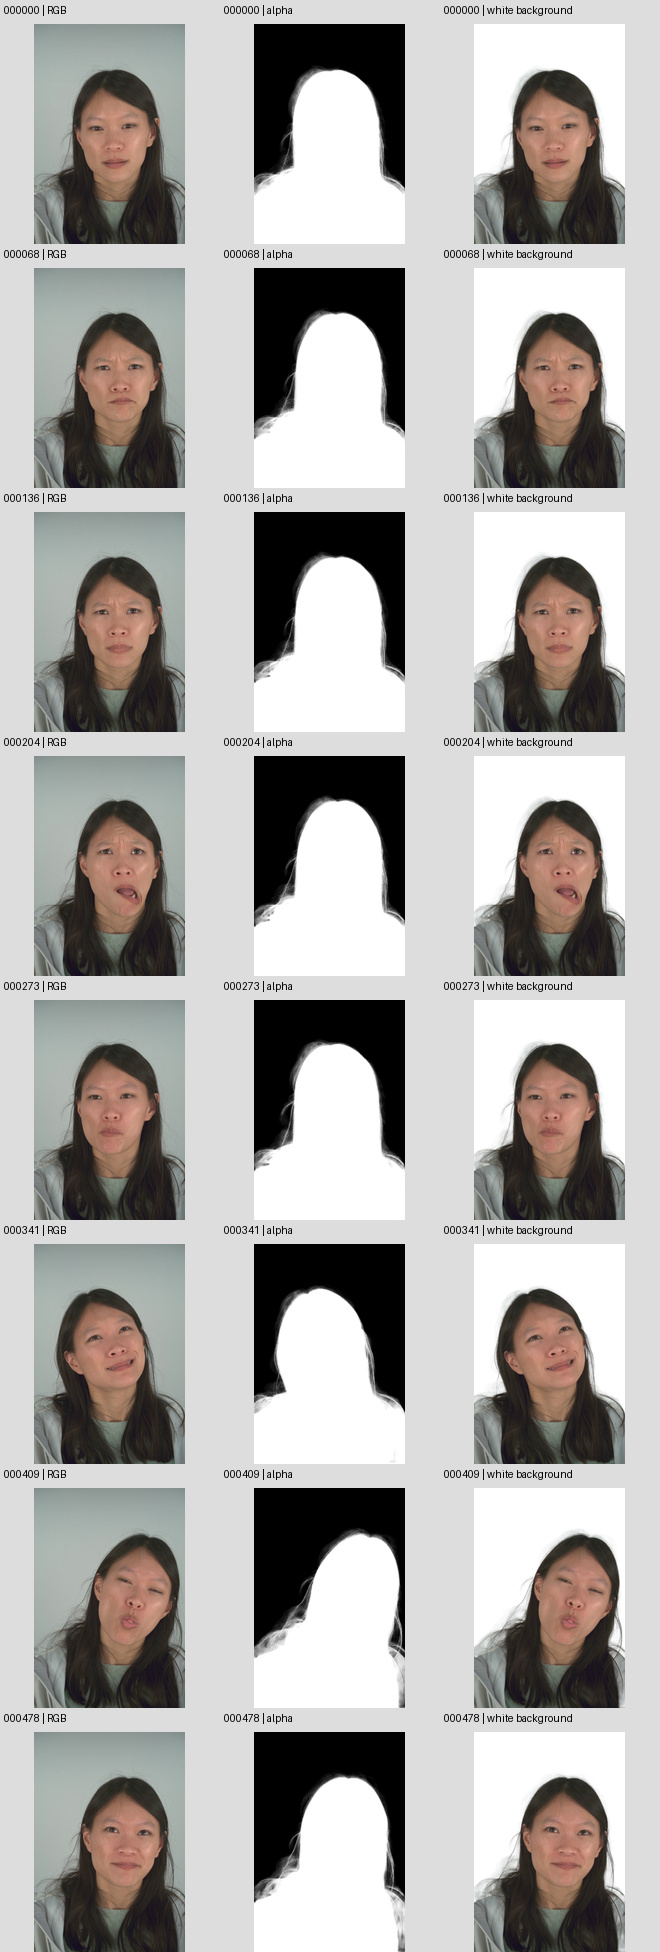
2단계 (VHAP) → detect landmarks → tracking → export(?)
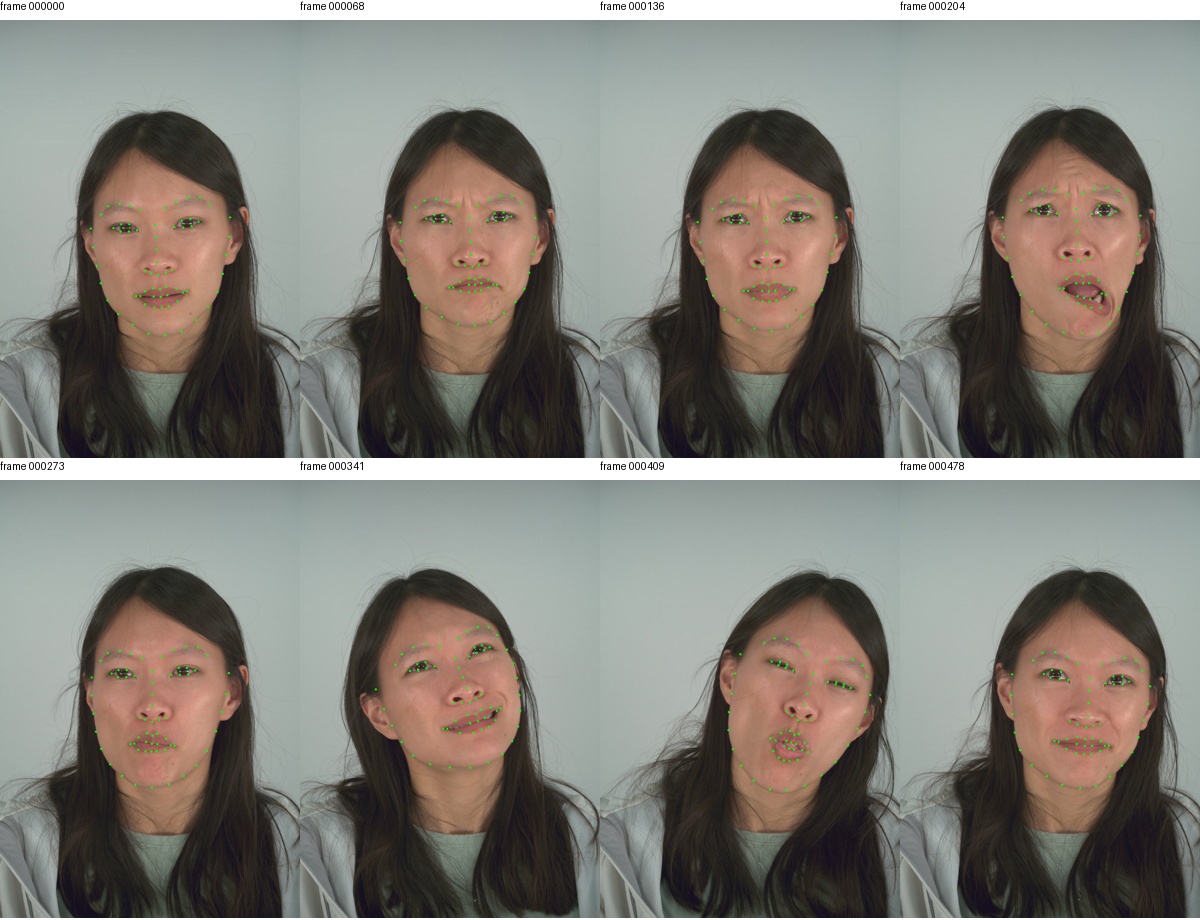
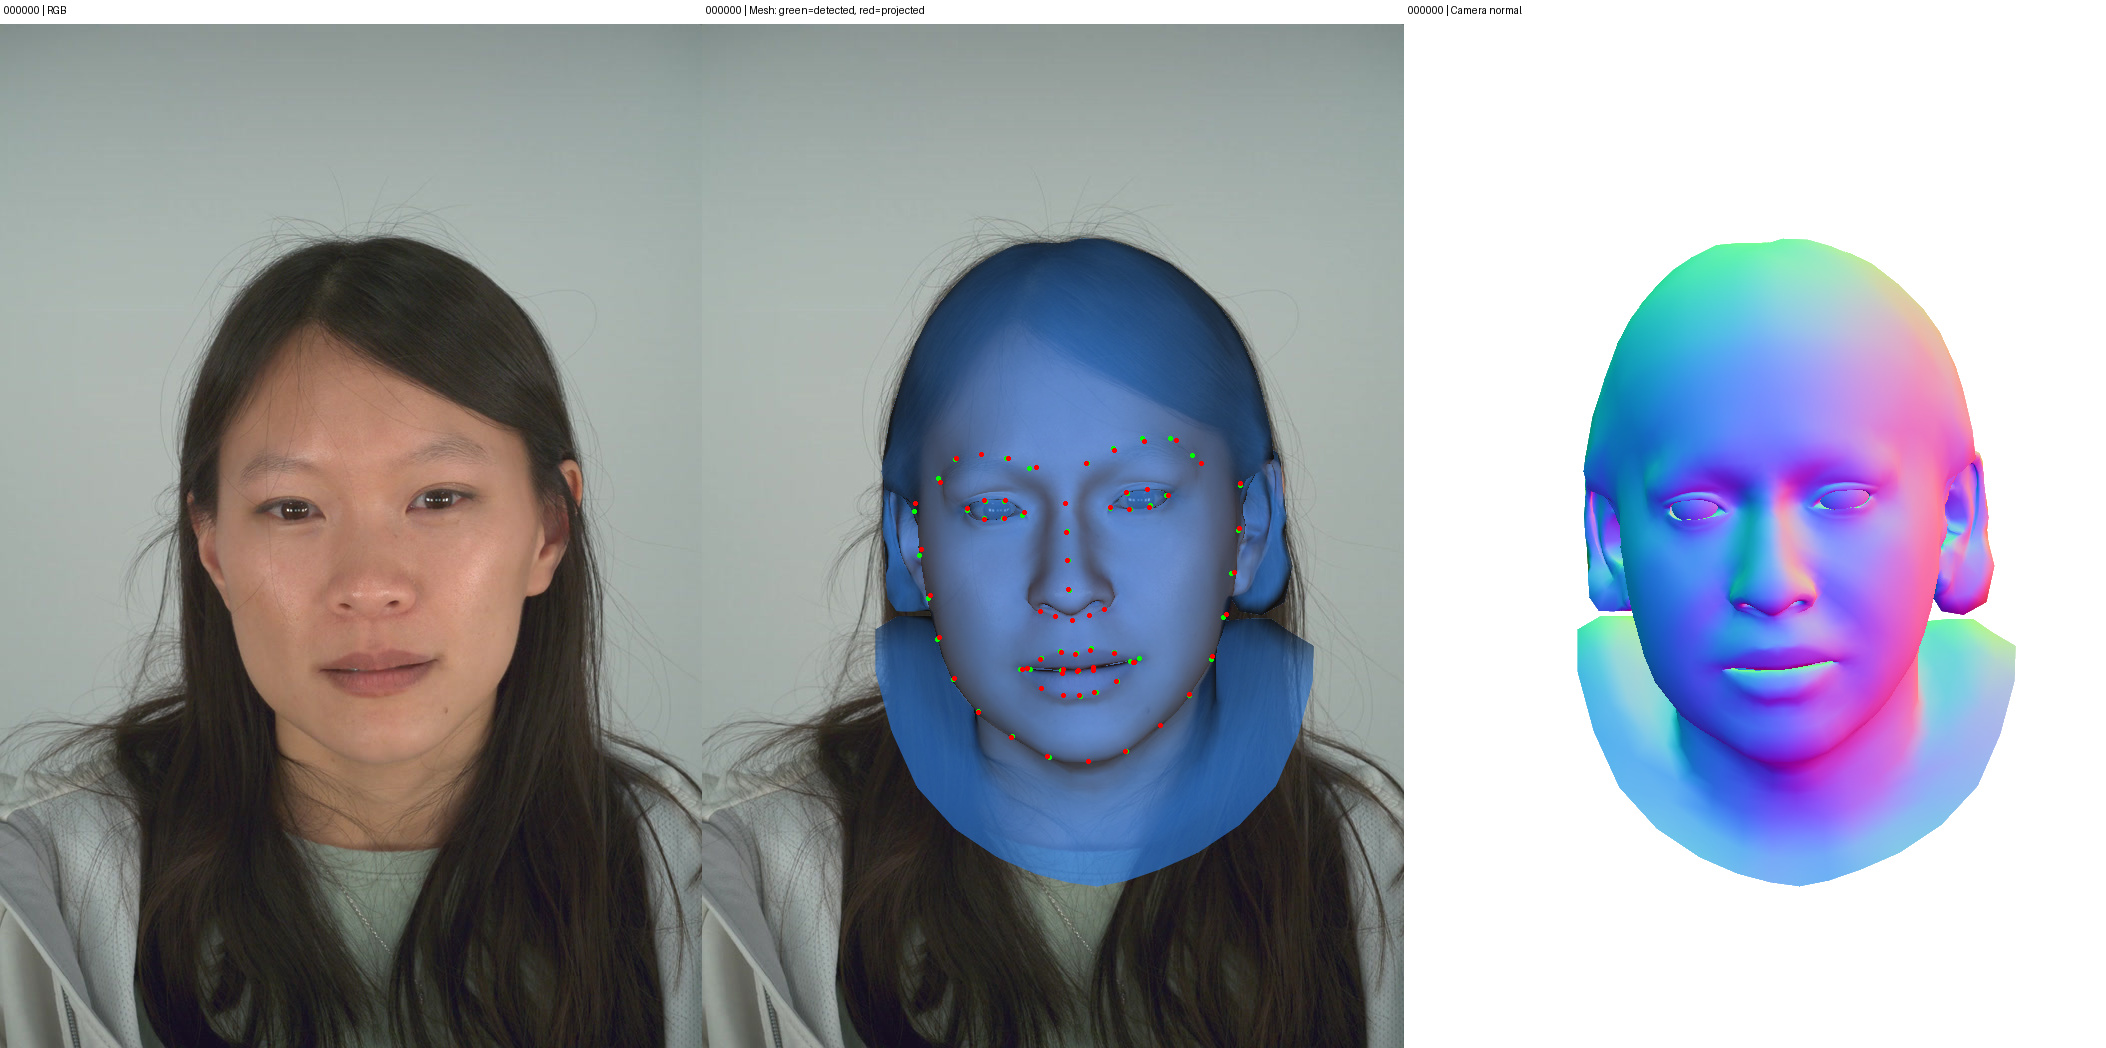
여기까지는 기존에 널리 쓰이는 VHAP을 사용하는 것이라 익숙하기도 하고 어렵지 않다.
2. Tracking result → Canonical UV Map (4)
앞에서 Mesh Tracking을 통해서 추출한 정보들을 이용해 Canonical Mesh UV Maps을 만든다. 이는 실제 FLAME 표면을 UV pixel로 1
대응시켜 색상(RGB), 위치(xyz), 대응점(index), 커버되지 않은 부분 등 다양하게 UV 형태로 Unwrapping시킬 수 있다.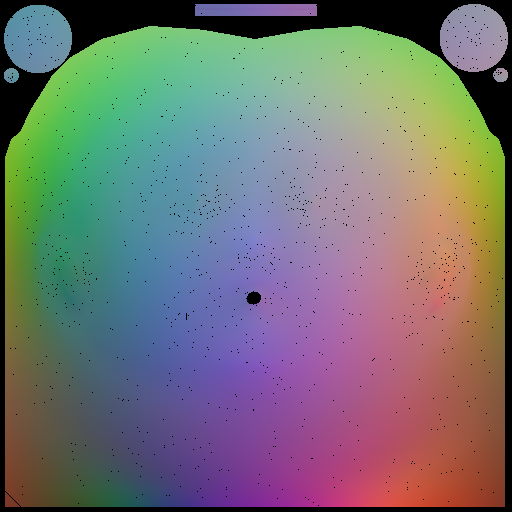
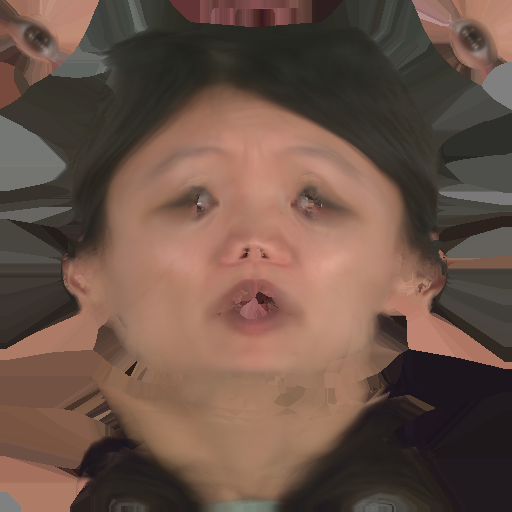
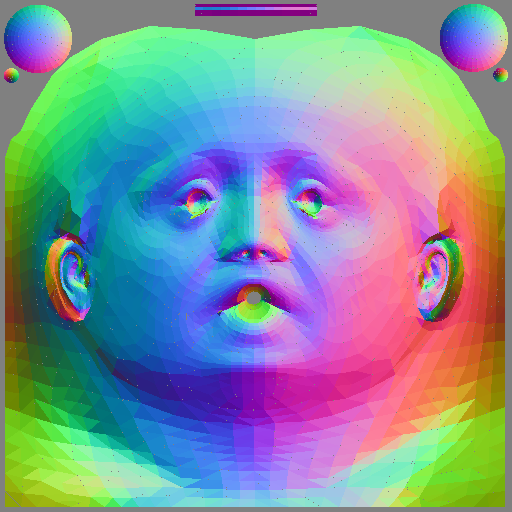
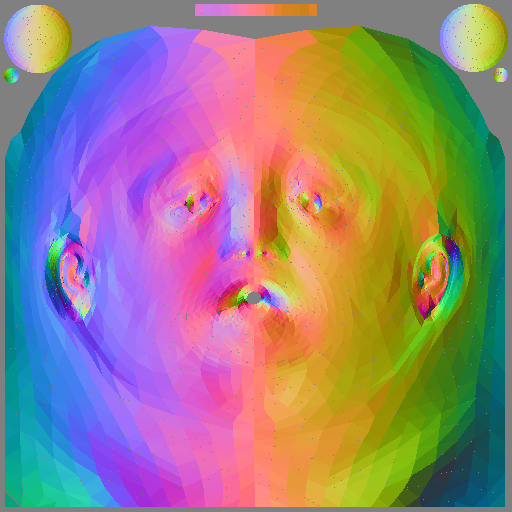
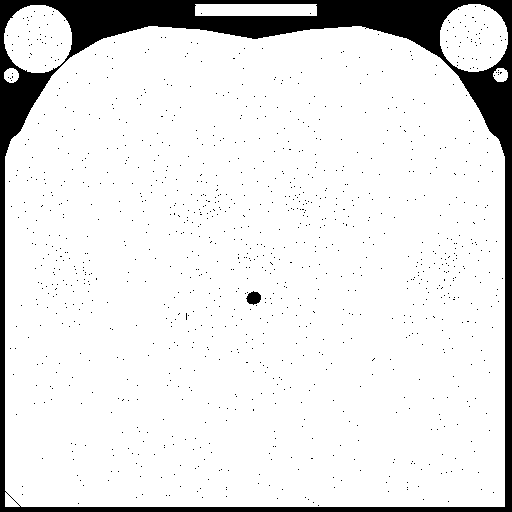
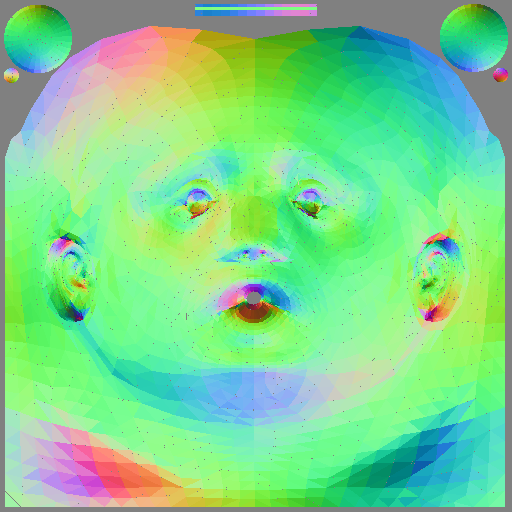
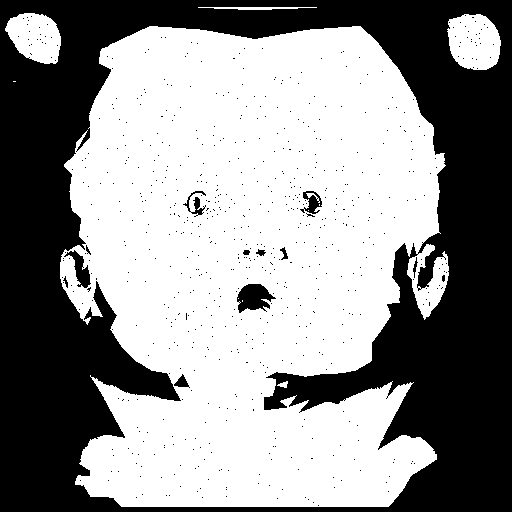
이렇게 완전히 대응되게 unwrapping 할 수 있는건 기존 FLAME Mesh가 가지고 있는 faces, vt, ft 덕분이며 이미 vertex의 정보들, 각 triangl mesh를 구성하는 vertex 조합, UV vertex의 2D 위치를 가지고 있게 된다.
이중 faces[k]와 ft[k]는 같은 표면 삼각형을 표현하게 되고 3D Vertex가 2D UV Vertex에 자연스럽게 대응이 되게 된다.
이제 UV좌표를 Rasterizer가 존재하는 clip 공간으로 바꾸어 UV평면 위의 삼각형들을 그리게 되다. texel 중심의 UV 좌표와 해당 texel이 대응하는 삼각형 번호를 얻게 되고 Barycentric을 이용해서 삼각형 내부 위치를 파악하게 되면, 이를 3D Vertex에 해당하는 점에 똑같이 대응하게 되어 해당 점에서의 대응하는 x,y,z를 얻게 된다.
xyz[row, col] = 해당 texel에 대응하는 표면 위치 (x,y,z)
pixel, depth = L03.project(points, K, w2c)
UV texel
   ↓ face + barycentric
프레임의 3D 표면 위치
   ↓ 카메라 projection
원본 영상의 이미지 좌표
   ↓ RGB sampling
그 texel에 들어갈 관측 색
3. UV represent → Gausian Map → 2DGS Avatar (5)
이번에는 본격적으로 앞에서 구한 UV Represent를 이용하여 Gaussian Map으로 변환하고 이를 실제 기본 FLAME Base model을 통하여 2DGS Avatar로 표현해본다.
SurfaceMap.decode 기존에는 학습을 통해서 initial된 Gaussian map에서 부터 점점 optimize되는 과정이지만 현재 이 곳에서는 FALEM Base model에 initial gaussian을 표현하여 이를 gaussian map으로 표현하는 과정부터 살펴보고자 한다.
기본적으로 정의를 하고 가자면, 입력으로 들어오는 geoemtry map과 appearance map 그리고 기본적으로 UV Texel에 대응하는 정보를 갖는 point와 rotation이다.
geometry_map = [B, 13, H, W] (Coarse local displacement 3, Fine local displacement 3, Scale 2, Rotation residual 4, opacity 1)
appearance_map = [B, 3, H, W] (RGB 값)
points = [B, H, W, 3] (각 Texel에 대응하는 FLAME 표면 위치)
Rotations = [B, H, W, 3, 3] (각 Texel의 표면 좌표계, TBN)
먼저 UV상에서의 유효한 Texel만 추려 Gaussian 목록으로 표현한다.
def flat(value):
    return value.reshape(b,h*w,*value.shape[3:])[:,self.indices]

geo = flat(geometry_map.permute(0,2,3,1))
app = flat(appearance_map.permute(0,2,3,1))
만약 N개라면 아래와 같이 표현될 수 있다.
geo : [B, N, 13]
app : [B, N, 3]
base : [[B, N, 3]
frame : [B, N, 3, 3]
이번 initial 때는 detail한 표현을 하지는 못하지만 coarse, fine displacement map을 이용하여 point의 위치를 같이 계산해준다. Normal 자체는 입력으로 들어온 Texel rotation을 이용하여 해당 normal 방향대로 displacement map을 이동시키어 기존 position을 변형시켜주게 된다.
그 외의 Gaussian의 scale, rotation ,opacity, color 등등 다양한 초기 계산을 진행하지만 스킵하고 다음과 같은 이미지들로 대체한다.
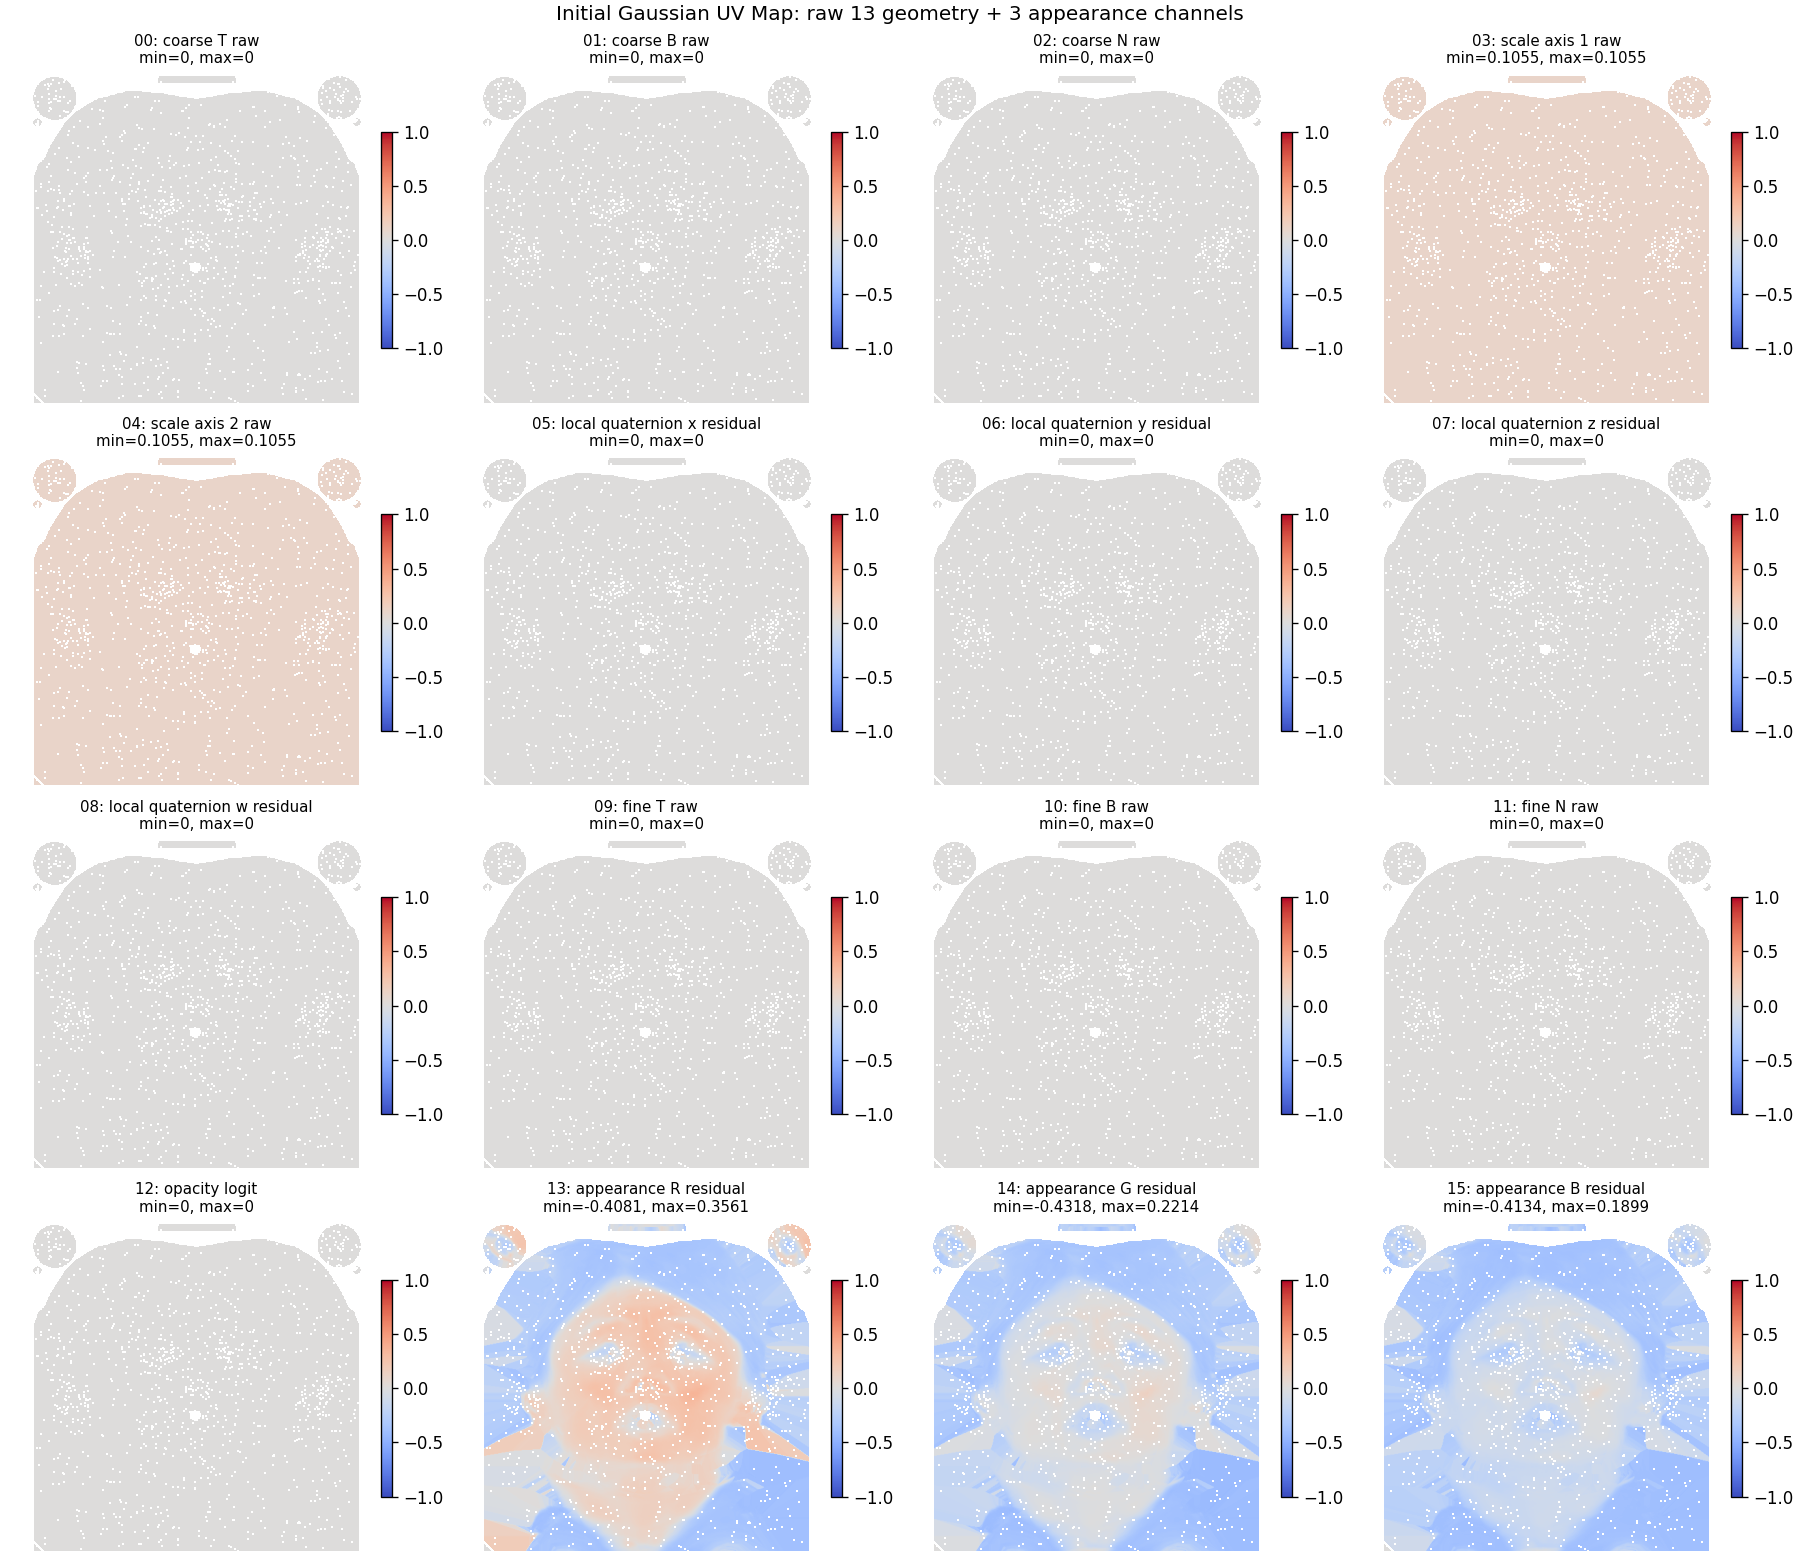
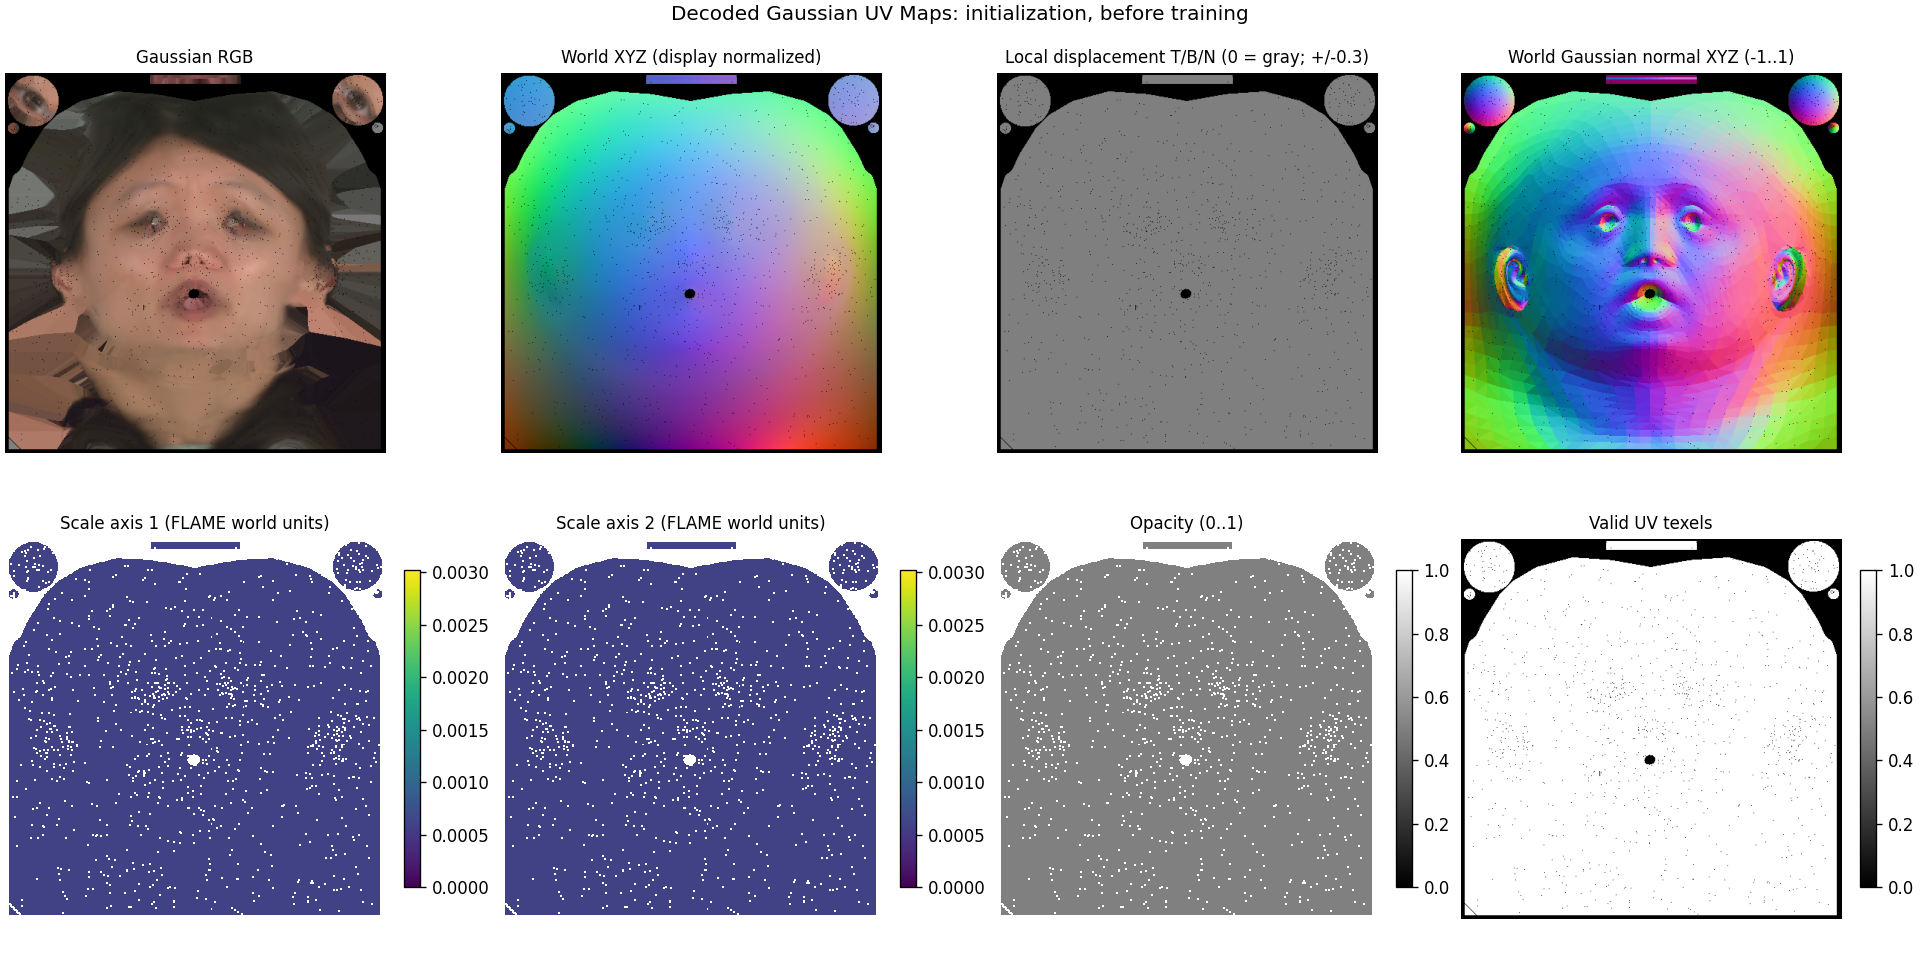
그럼 이렇게 입력으로 들어온 Network 출력 UV Map에 대하여 고정된 Decoding 수식을 통하여 Gaussian Rendering을 하게 되면 아래와 같은 2D Gaussian Rendering이 가능하게 된다.
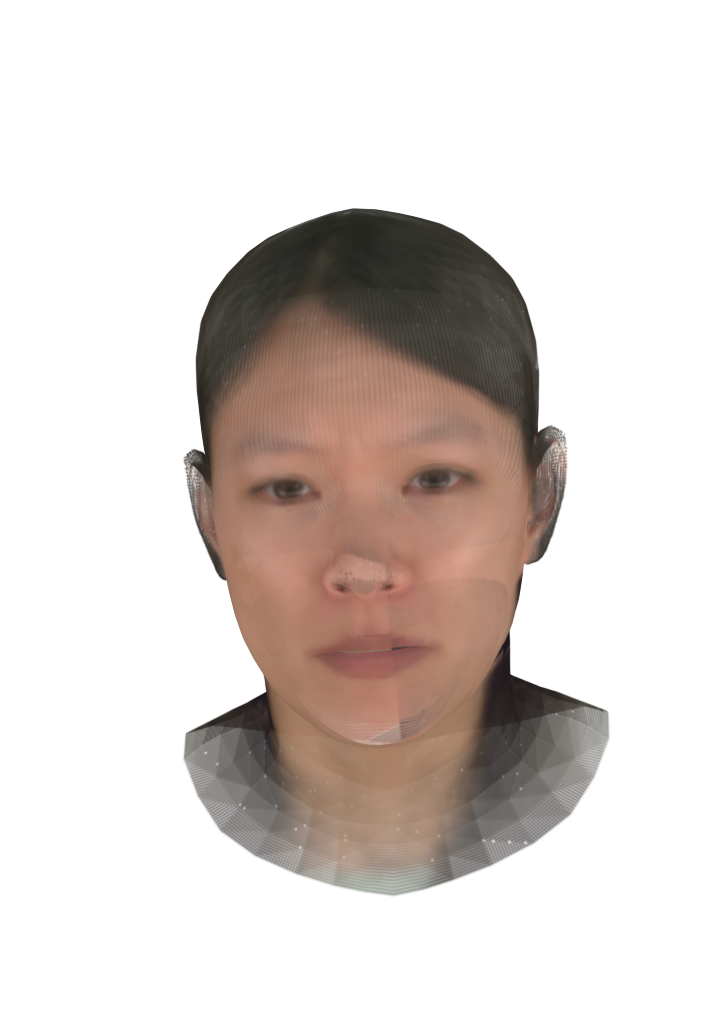
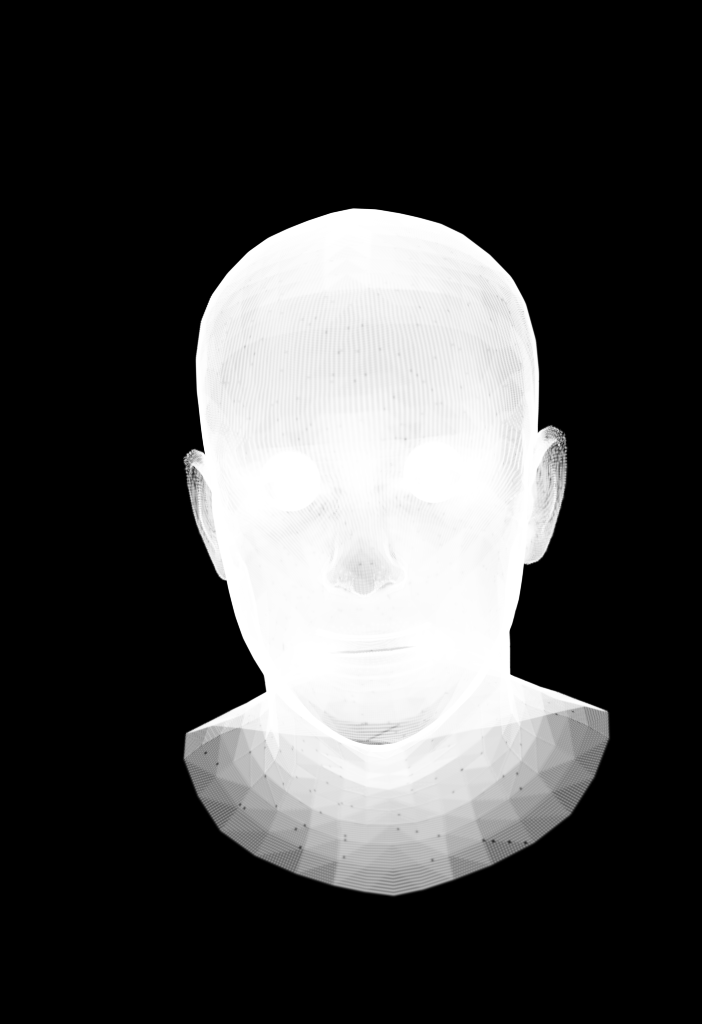
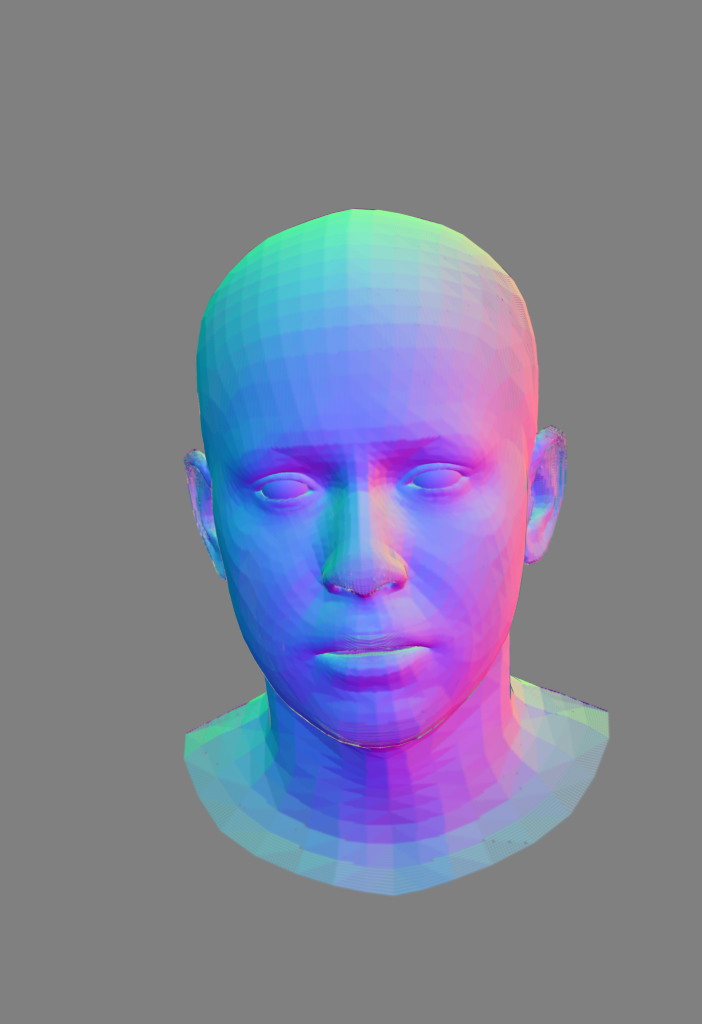
물론 우리의 목적은 이러한 Initial Gaussian Map으로부터 2DGS Render를 한 이미지에서 실제 이미지와의 Loss를 통해 Update되게 된다. 여기서 중요한 점은 Update되는 주체는 무엇인가? 이다. 단순하게 생각하면 입력으로 들어오는 Map을 바꾼다고 생각할 수도 있겠지만(나는 그랬다), 아래 이미지와 같이 입력으로 들어오는 UV Map을 통해서 Gaussian Map (Geo 13, App 3)으로 변환하는 Network 자체를 학습하는 것이 main task인 것이다. 이렇게 알아보면 아래의 구조 자체가 굉장히 직관적으로 느껴지게 된다. 정말 trainable한 부분이 잘 보이게 된다.
4. Avatar Training (6, 7, 8)
Mesh2Gaussian Network 읽는 순서: Mesh2Gaussian.forward -> ExprEncoder -> SongUNet -> UNetBlock -> UNetWBConcat -> weight_norm_wrapper/glorot.
중요한 질문들
-
같은 canonical RGB/XYZ인데 프레임마다 GaussianMap이 어떻게 달라지는가? 왜 달라지는가?
-
[B, 128] driving이 [B,C,H,W]의 UV 위치별 변화를 어떻게 조건화 하는가?
-
Backbond의 16채널 feature와 최종 13+3채널 Gaussian parameter는 어떻게 다른가?
-
Network가 예측하는 residual과 FLAME 자체의 표정/pose 변화는 어디서 합쳐지는가?
-
고정 decoding/rendering을 지나 loss가 어떤 파라미터까지 돌아가는가?
-
입력으로 들어오는 frame별의 FLAME 관측값인
parameters값들을self.encoder(batch)로 들어가게 된다. 이곳 Encoder에서는 driving 값들을 embedding하게 되는데 한마디로 tracked FLAME 수치를 Latent vector로 encoding한다는 의미이다. 입력으로 들어오는 FLAME Parameter들에 대하여 기본적으로 Projection을 시키는데 이는 쉽게 보면 expression을 학습 가능하게 Linear matrix로 표현한다는 것이다. 예를 들어,expression x: [B, 100]'이라고 할 때weight w: [128,100],bias b: [128]로 두어x @ w.T + b`형태로 표현할 수 있게 해주는 것이다. 여기서 말하는 Projection은 일반적으로 3D -> 2D 형태로 Projection의 느낌 보다는 learned feature transformation의 의미를 강하게 가진다. 다음으로 이렇게 학습 가능하게 변한 표현들은 다른 표현들과의 관계성을 가지지 못하기 때문에 이를 MLP를 사용함으로서 서로의 관계 조합에 영향을 받으면서 처리할 수 있게 해준다.
전체적인 흐름은 다음과 같다.
Each Project -> Concat -> MLP (256->128) -> Driving embedding
이렇게 보면 입력으로 들어온 100차원의 expression들을 128차원으로 늘리면서도 개별적으로, 또 서로 같이 학습을 할 수 있는 이러한 Network로 구성된 것을 확인할 수 있다.
- Decoder에는 입력으로
uv_input(canonical)과 앞에서 작업한embds를 입력으로 받아 들어가게 된다.
uv_input: [B, 6, 512, 512] (Canonical RGB 3ch + normalized XYZ 3ch)
embds: [B, 128] (ExprEncoder에서 만든 embedding)
원하는 출력은 [B, 16, 512, 512]차원으로 geometry/appearance head가 사용할 shared feature이다.
사실 여기서부터는 EDM논문의 SongUNet을 사용했다고 나와있어서 이거 하나가 꽤나 큰 Architecture라 설명하고 이해하기 너무 방대하다...(귀찮다는 뜻) 이것을 이해하기 위해서는 Elucidating the Design Space of Diffusion-Based Generative Models(NeurIPS 2022)를 보는게 좋을 것 같다. 여기서 사용된 SongUNet 구조 자체는 diffusion 연구에서 발전한 U-Net 구조(효율적인, 정확한...)를 가져와서 Avatar 도메인의 Gaussian parameter 생성이라는 다른 학습 문제에 사용하는 정도이다.
Dataset & Loss
ELITE 논문에서도 나와있듯이 Loss자체는 L1, SSIM, LPIPS + 2DGS Loss를 사용한다고 나와있다.
Train Avatar
실제 학습 파이프라인 자체는 다음과 같이 이루어진다.
frame sample -> UV/driving -> Mesh2Gaussian Network -> Gaussian decoding -> 2DGS Render -> Loss -> Backward
이 과정에서 학습하는 곳은 Mesh2Gaussian Network이고 안에서의 Encoder(expr), Decoder(SongUNet)가 학습이 진행된다.
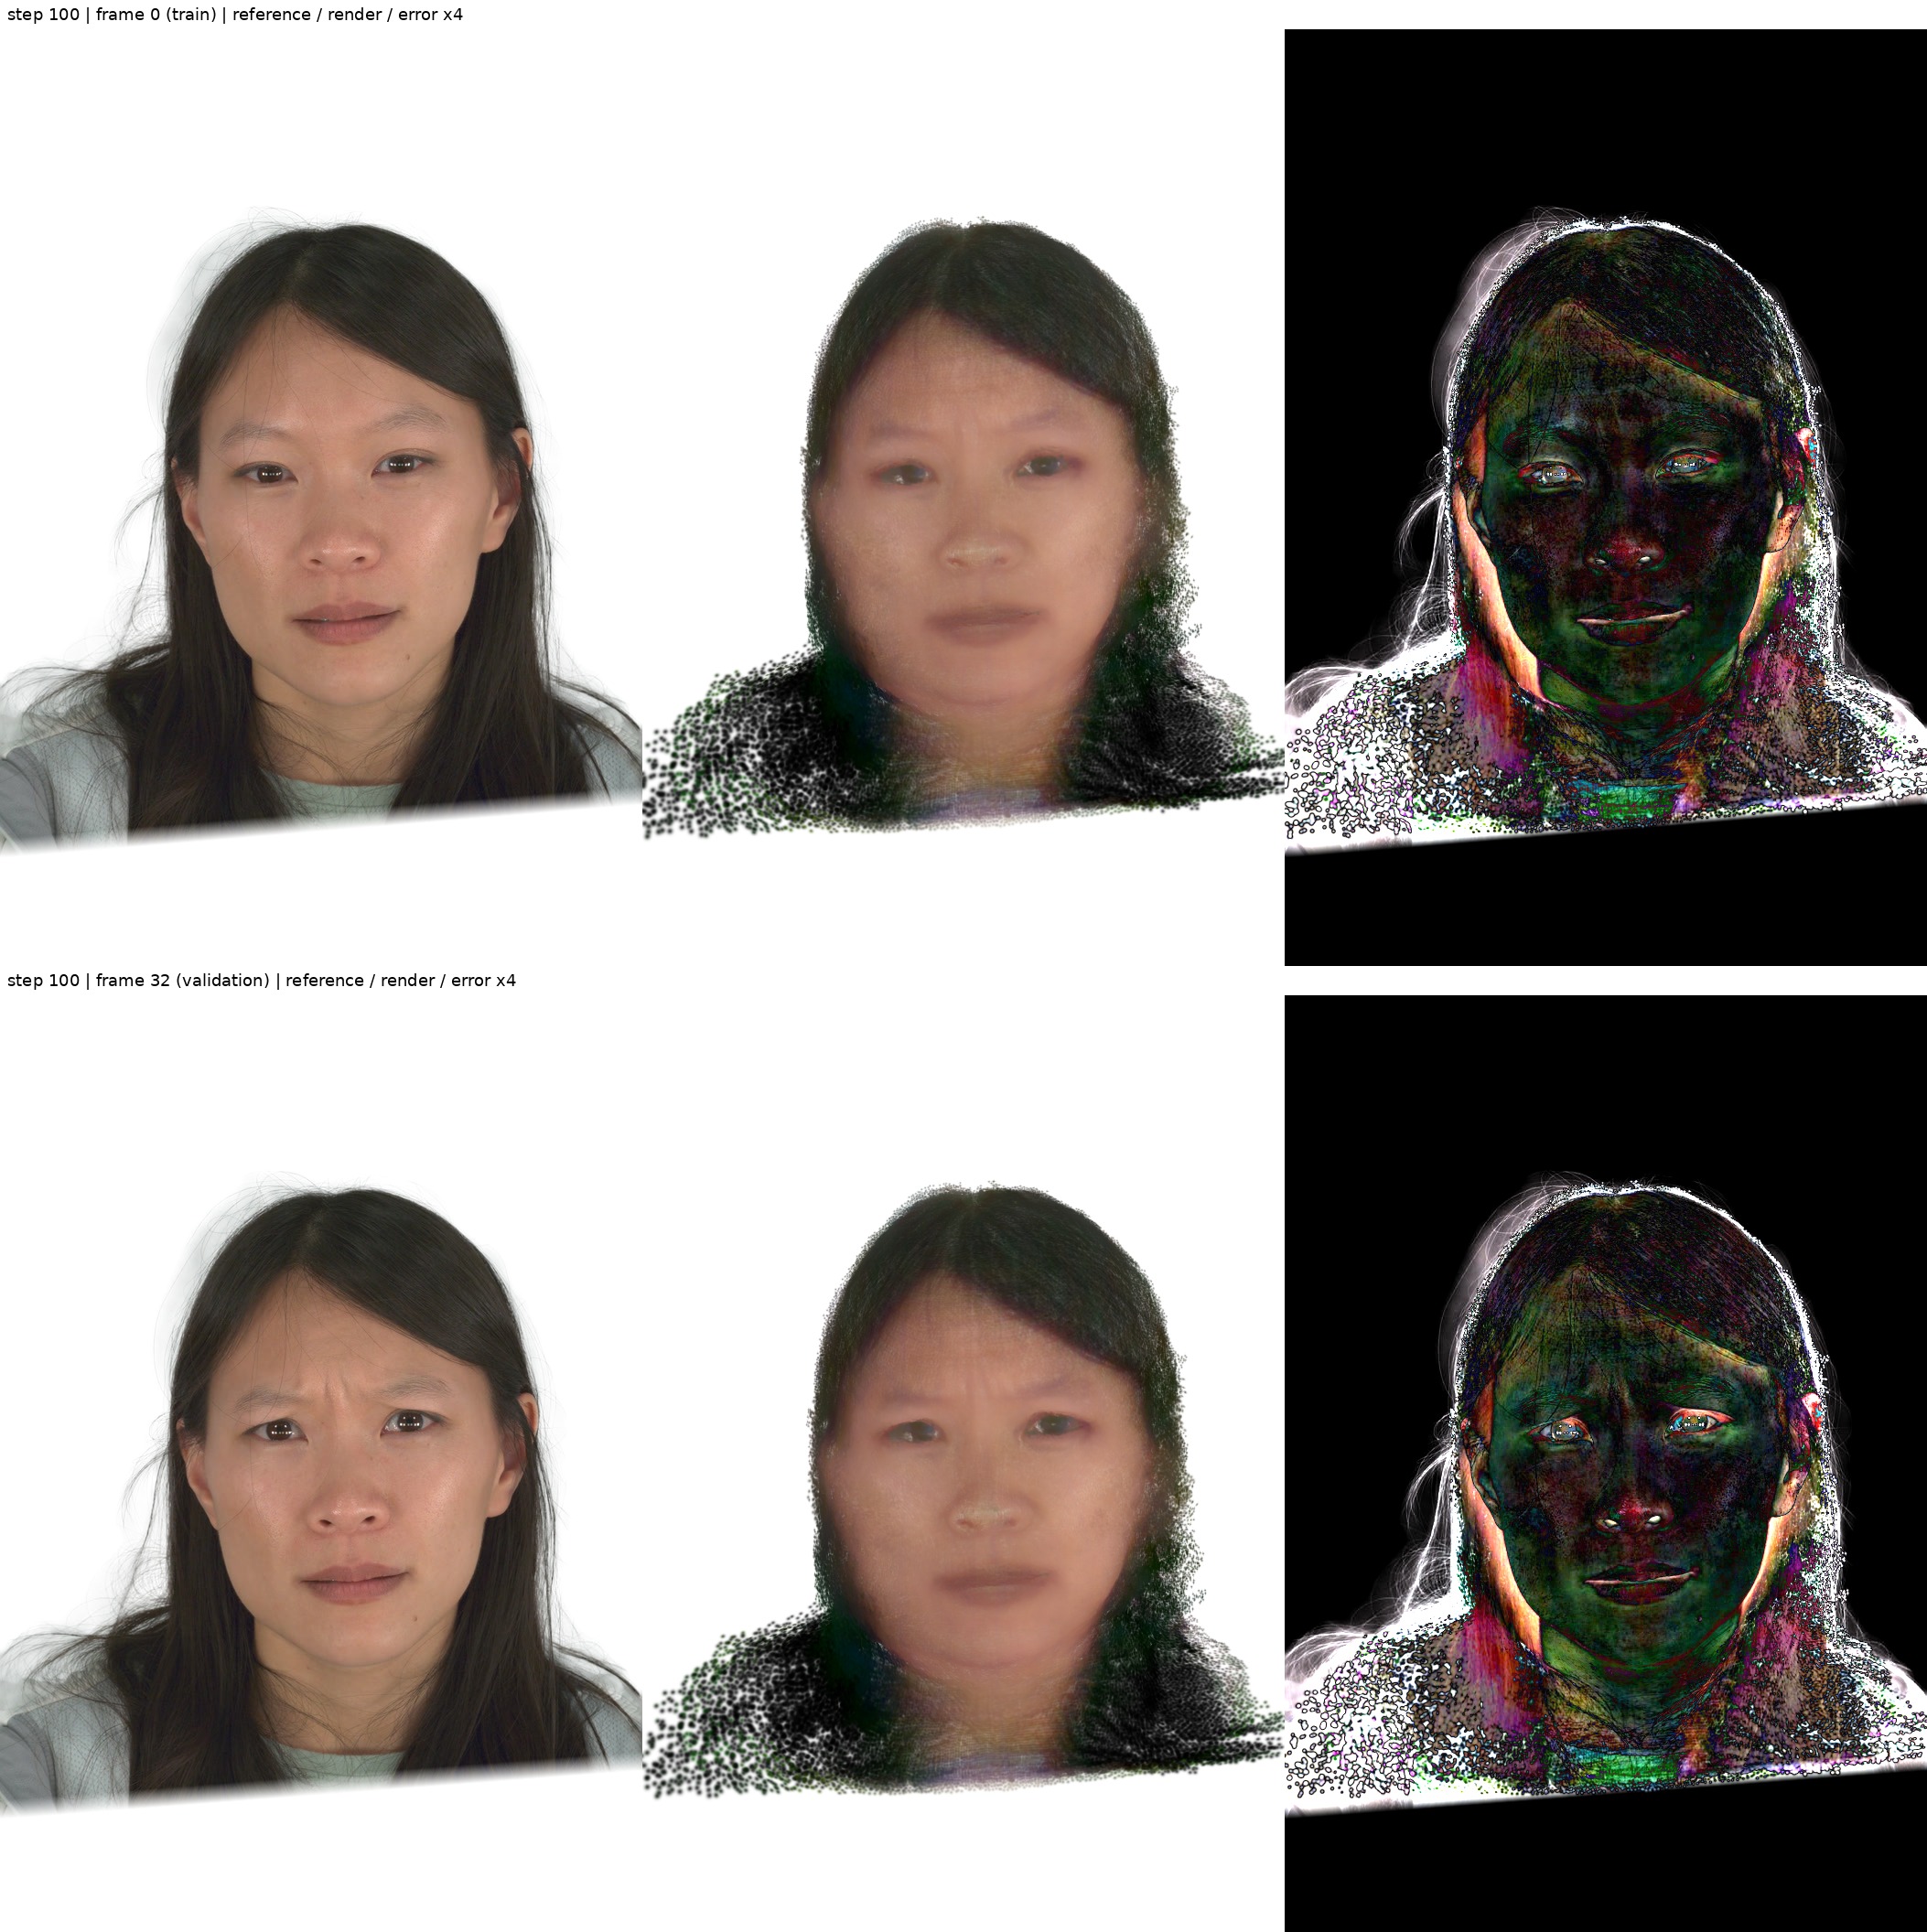
30k 학습이라 오래걸리네요.(10/11 1
학습이 모두 끝나고 결과는 아래와 같이 나왔다.
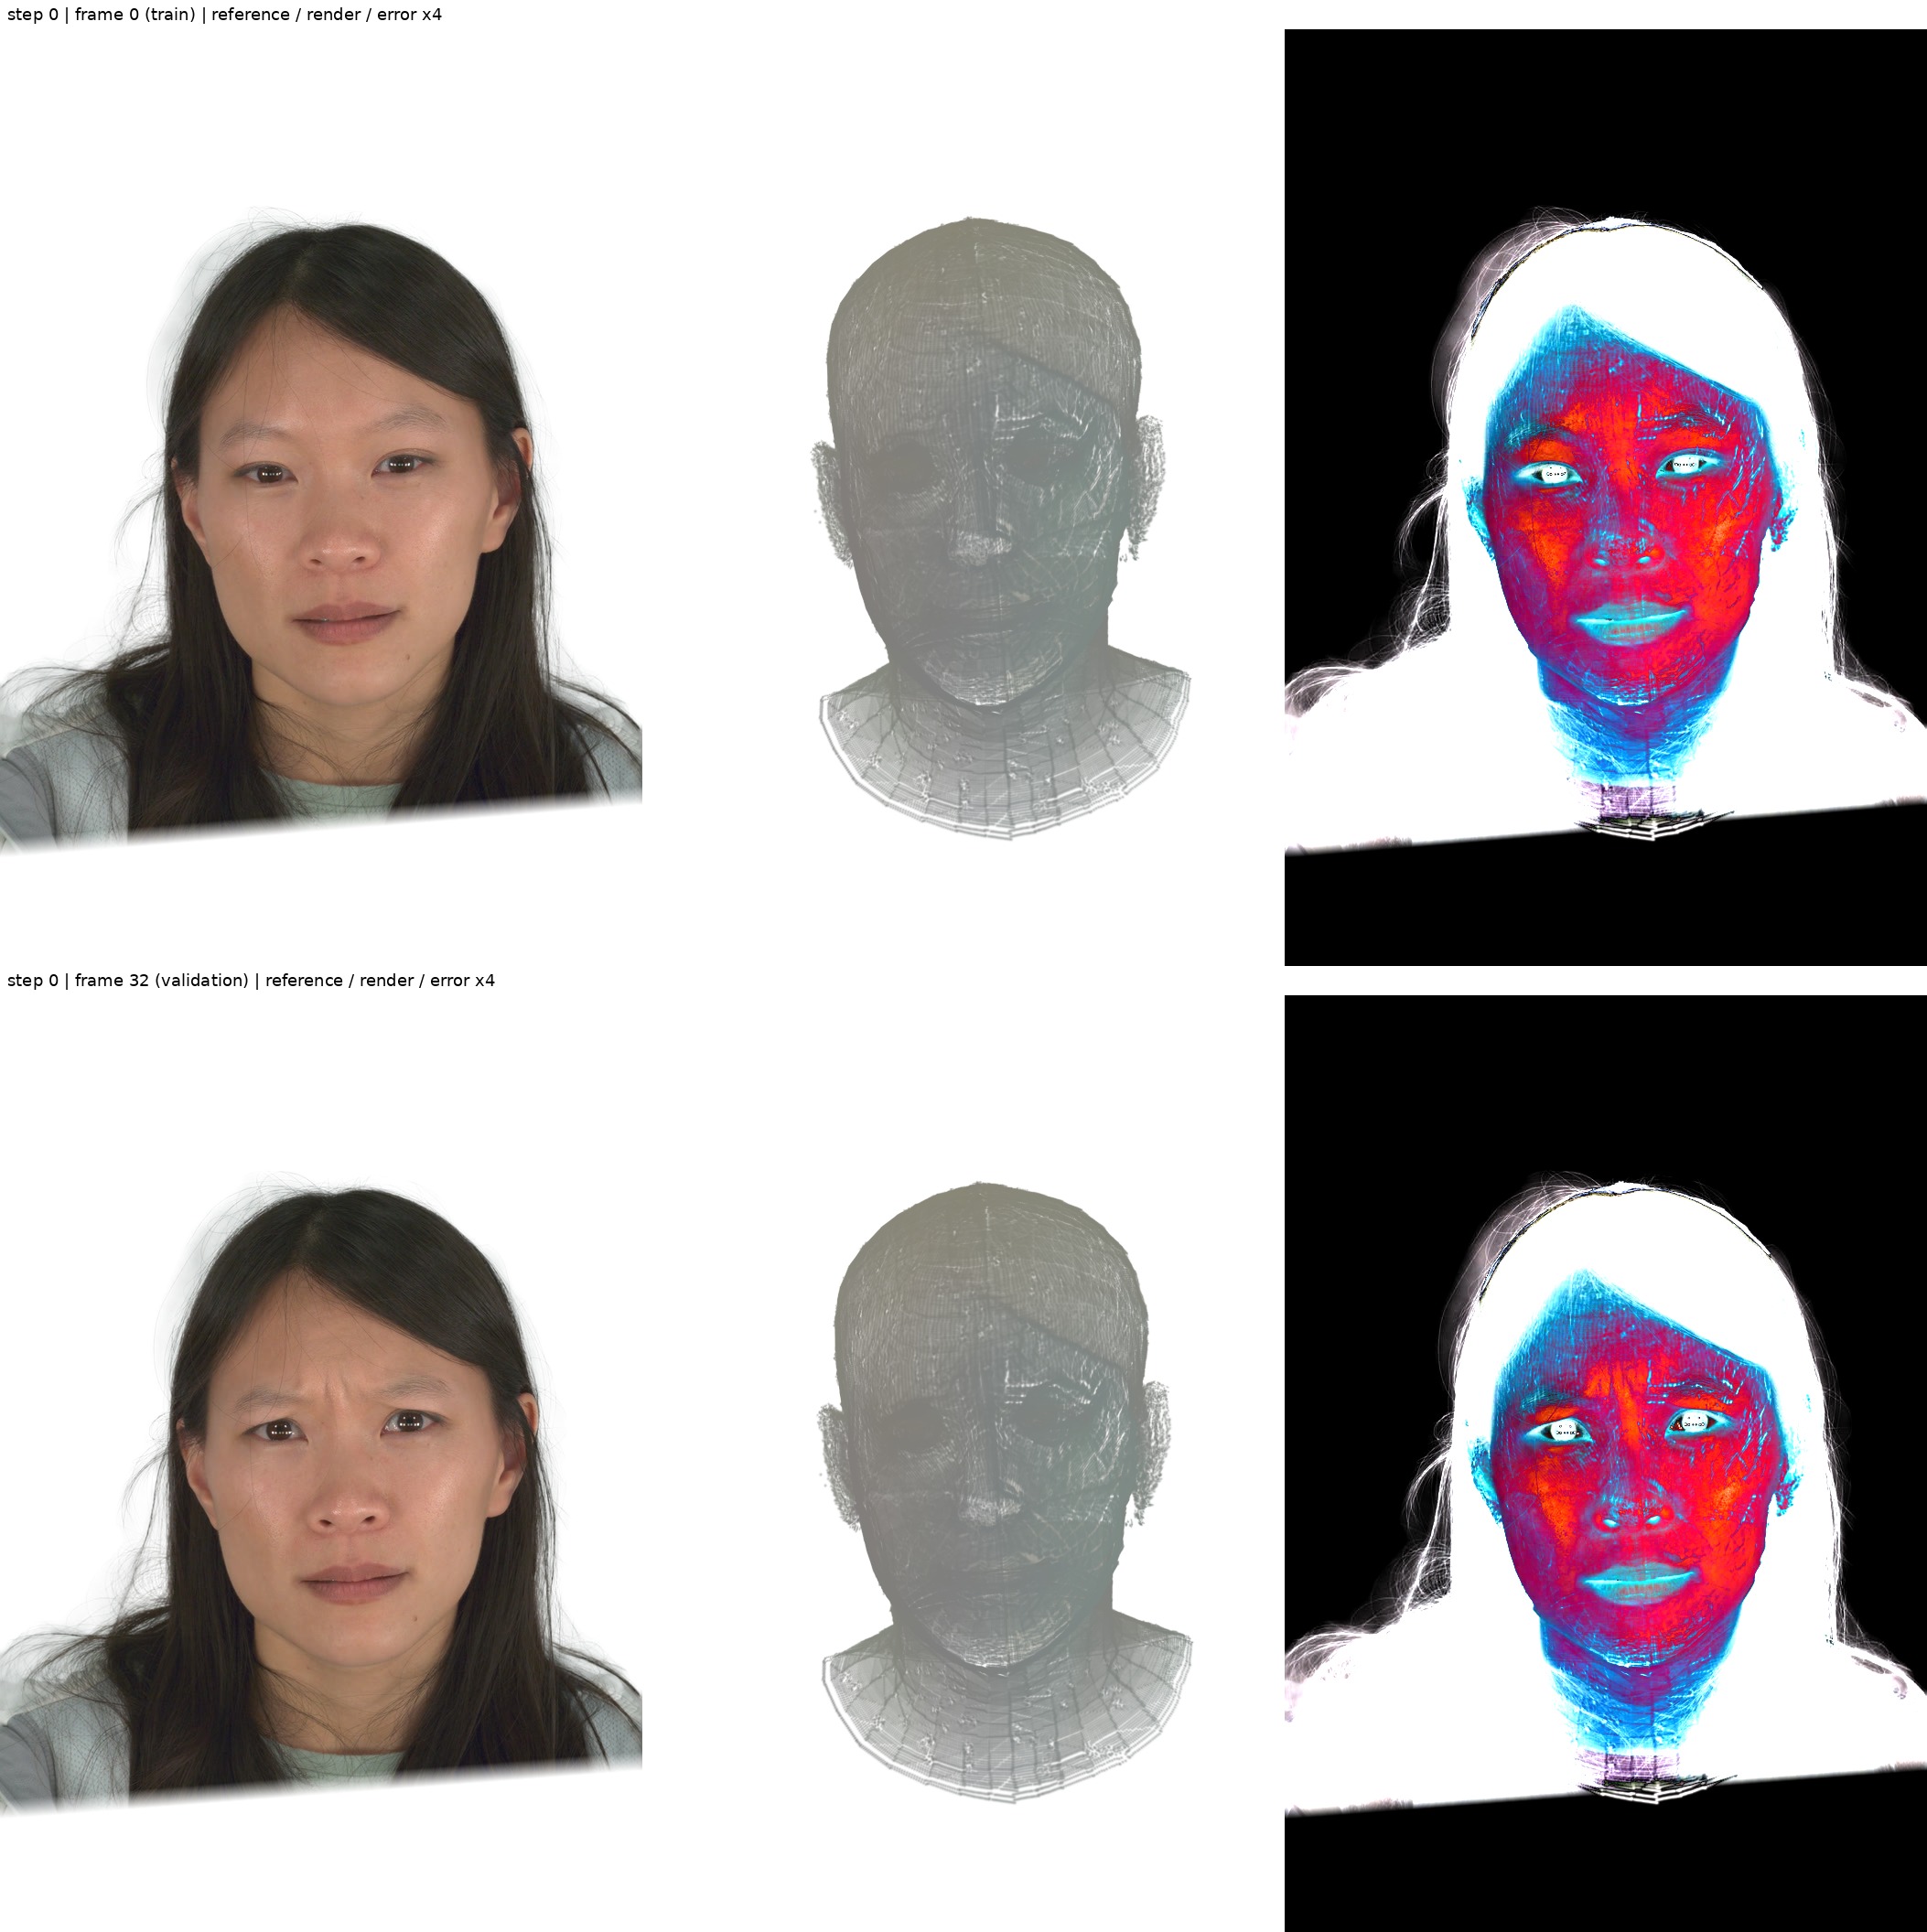
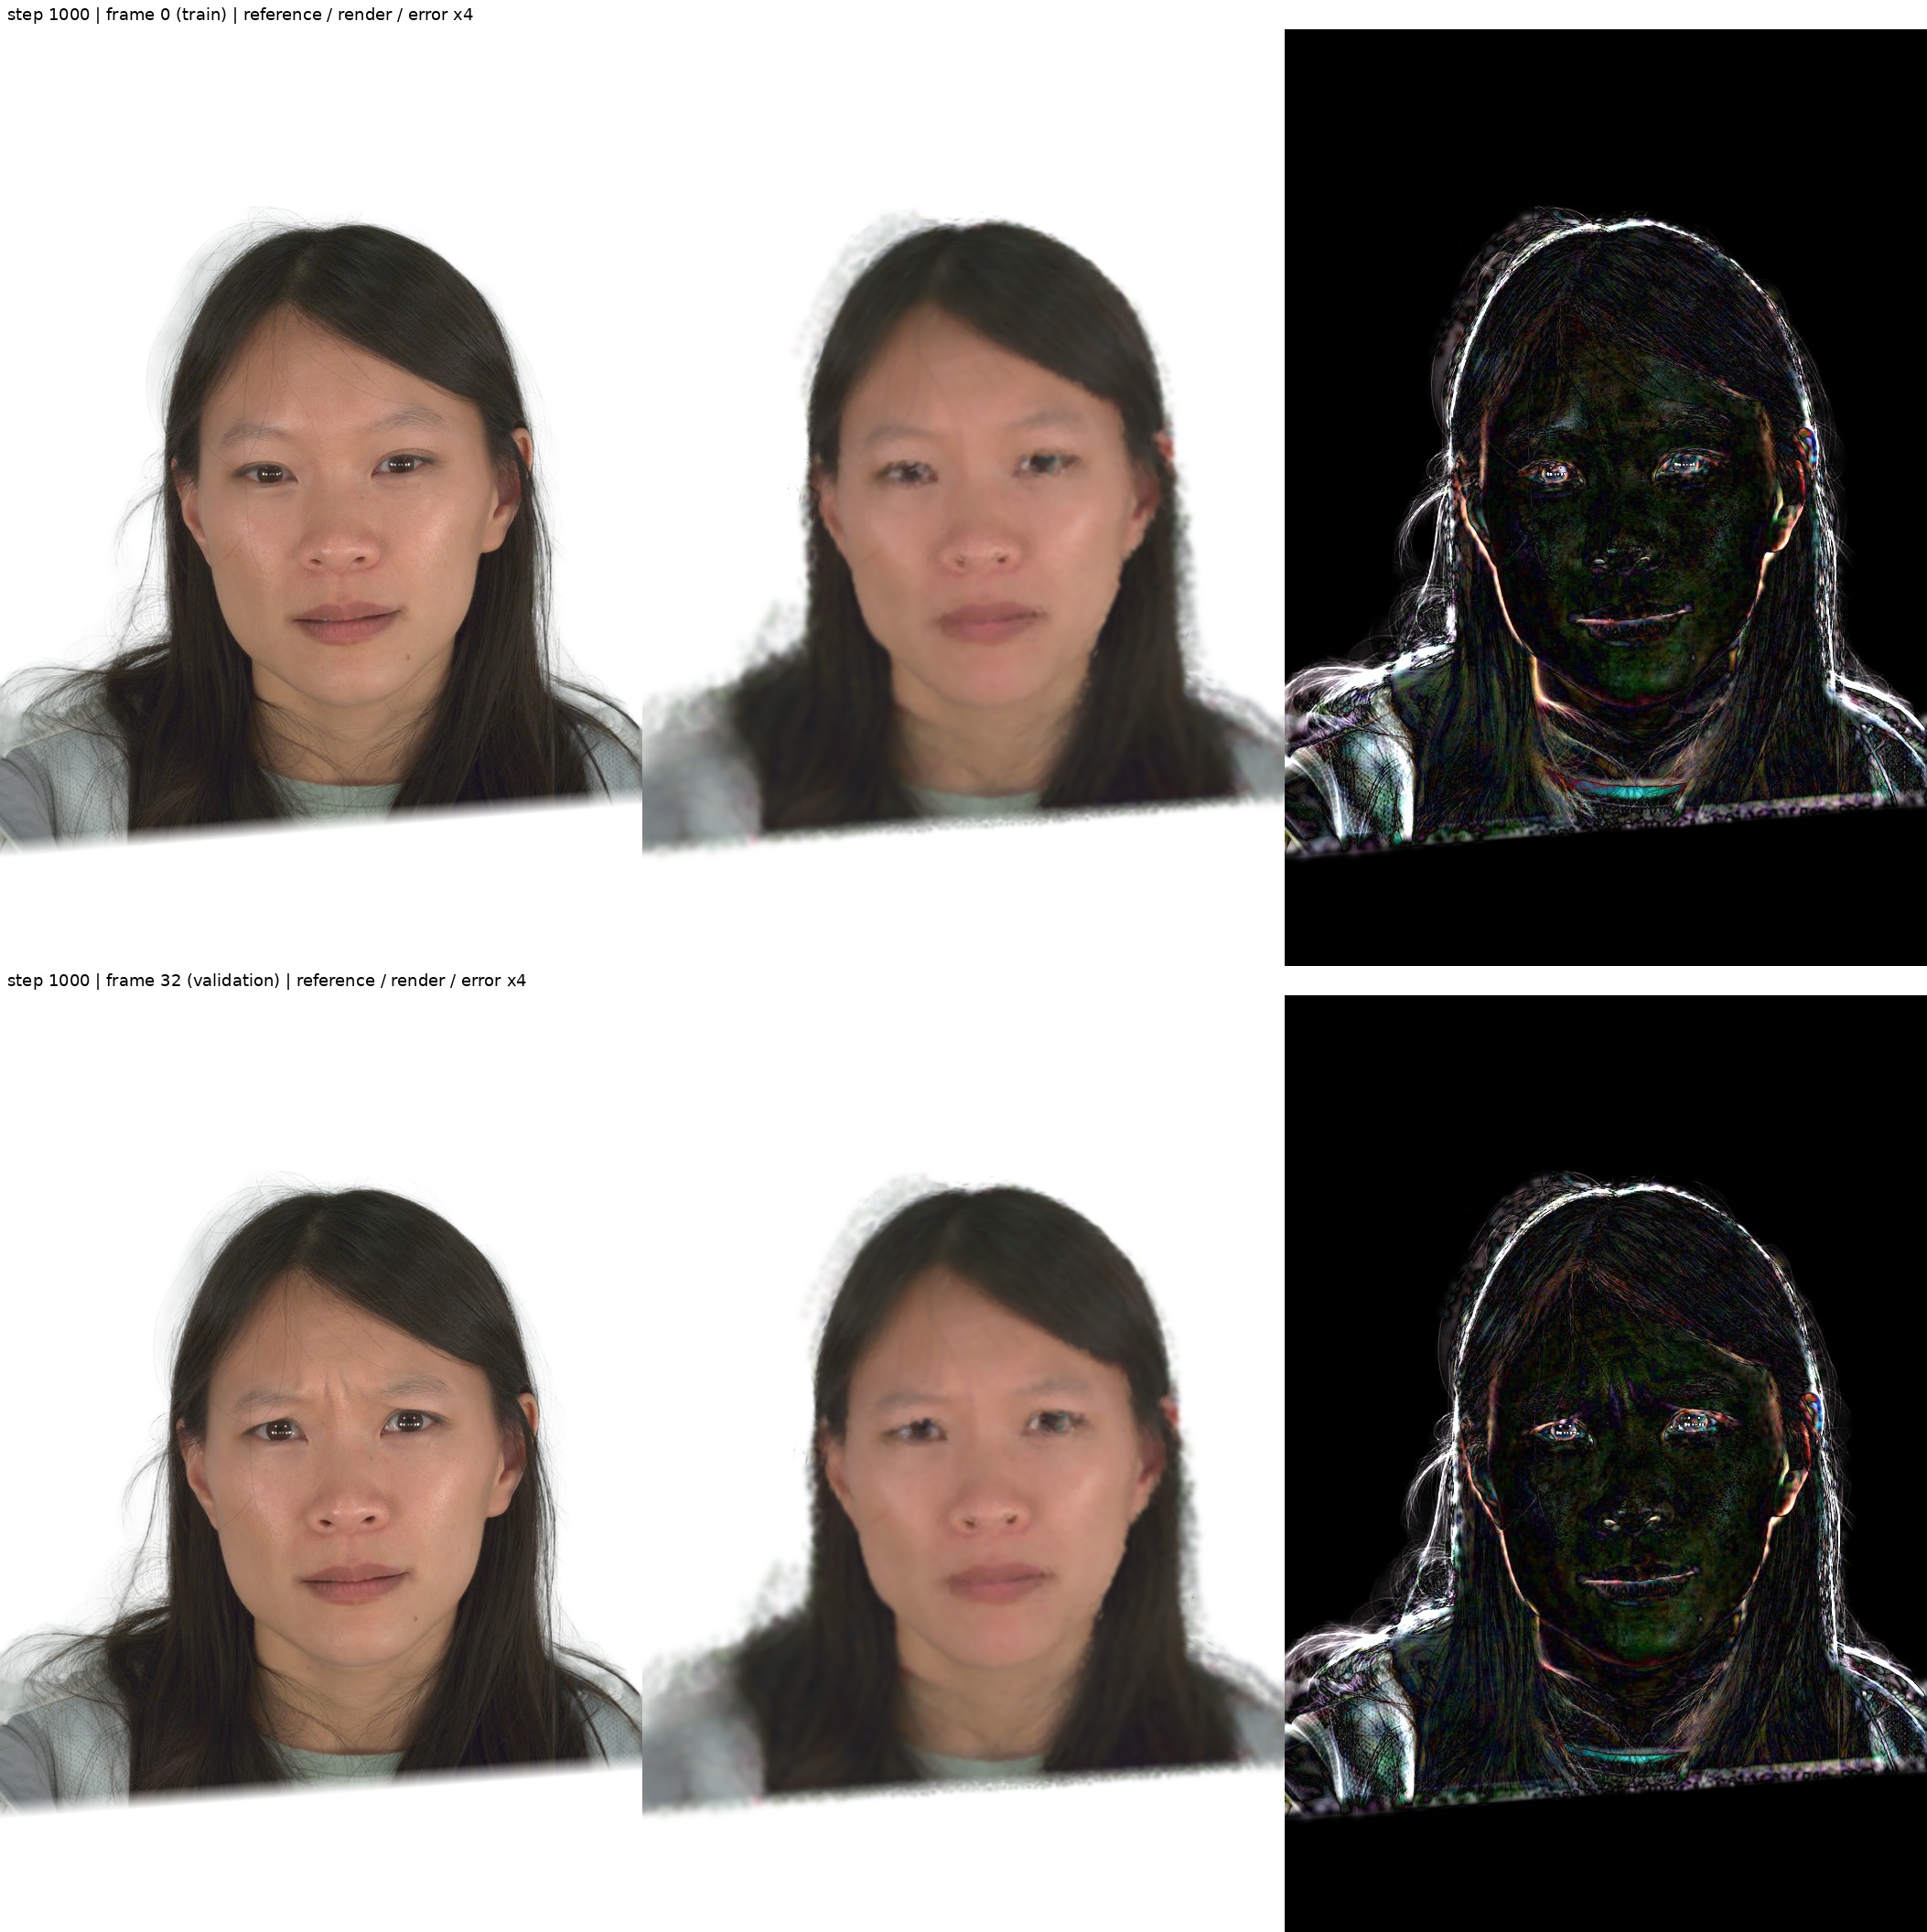
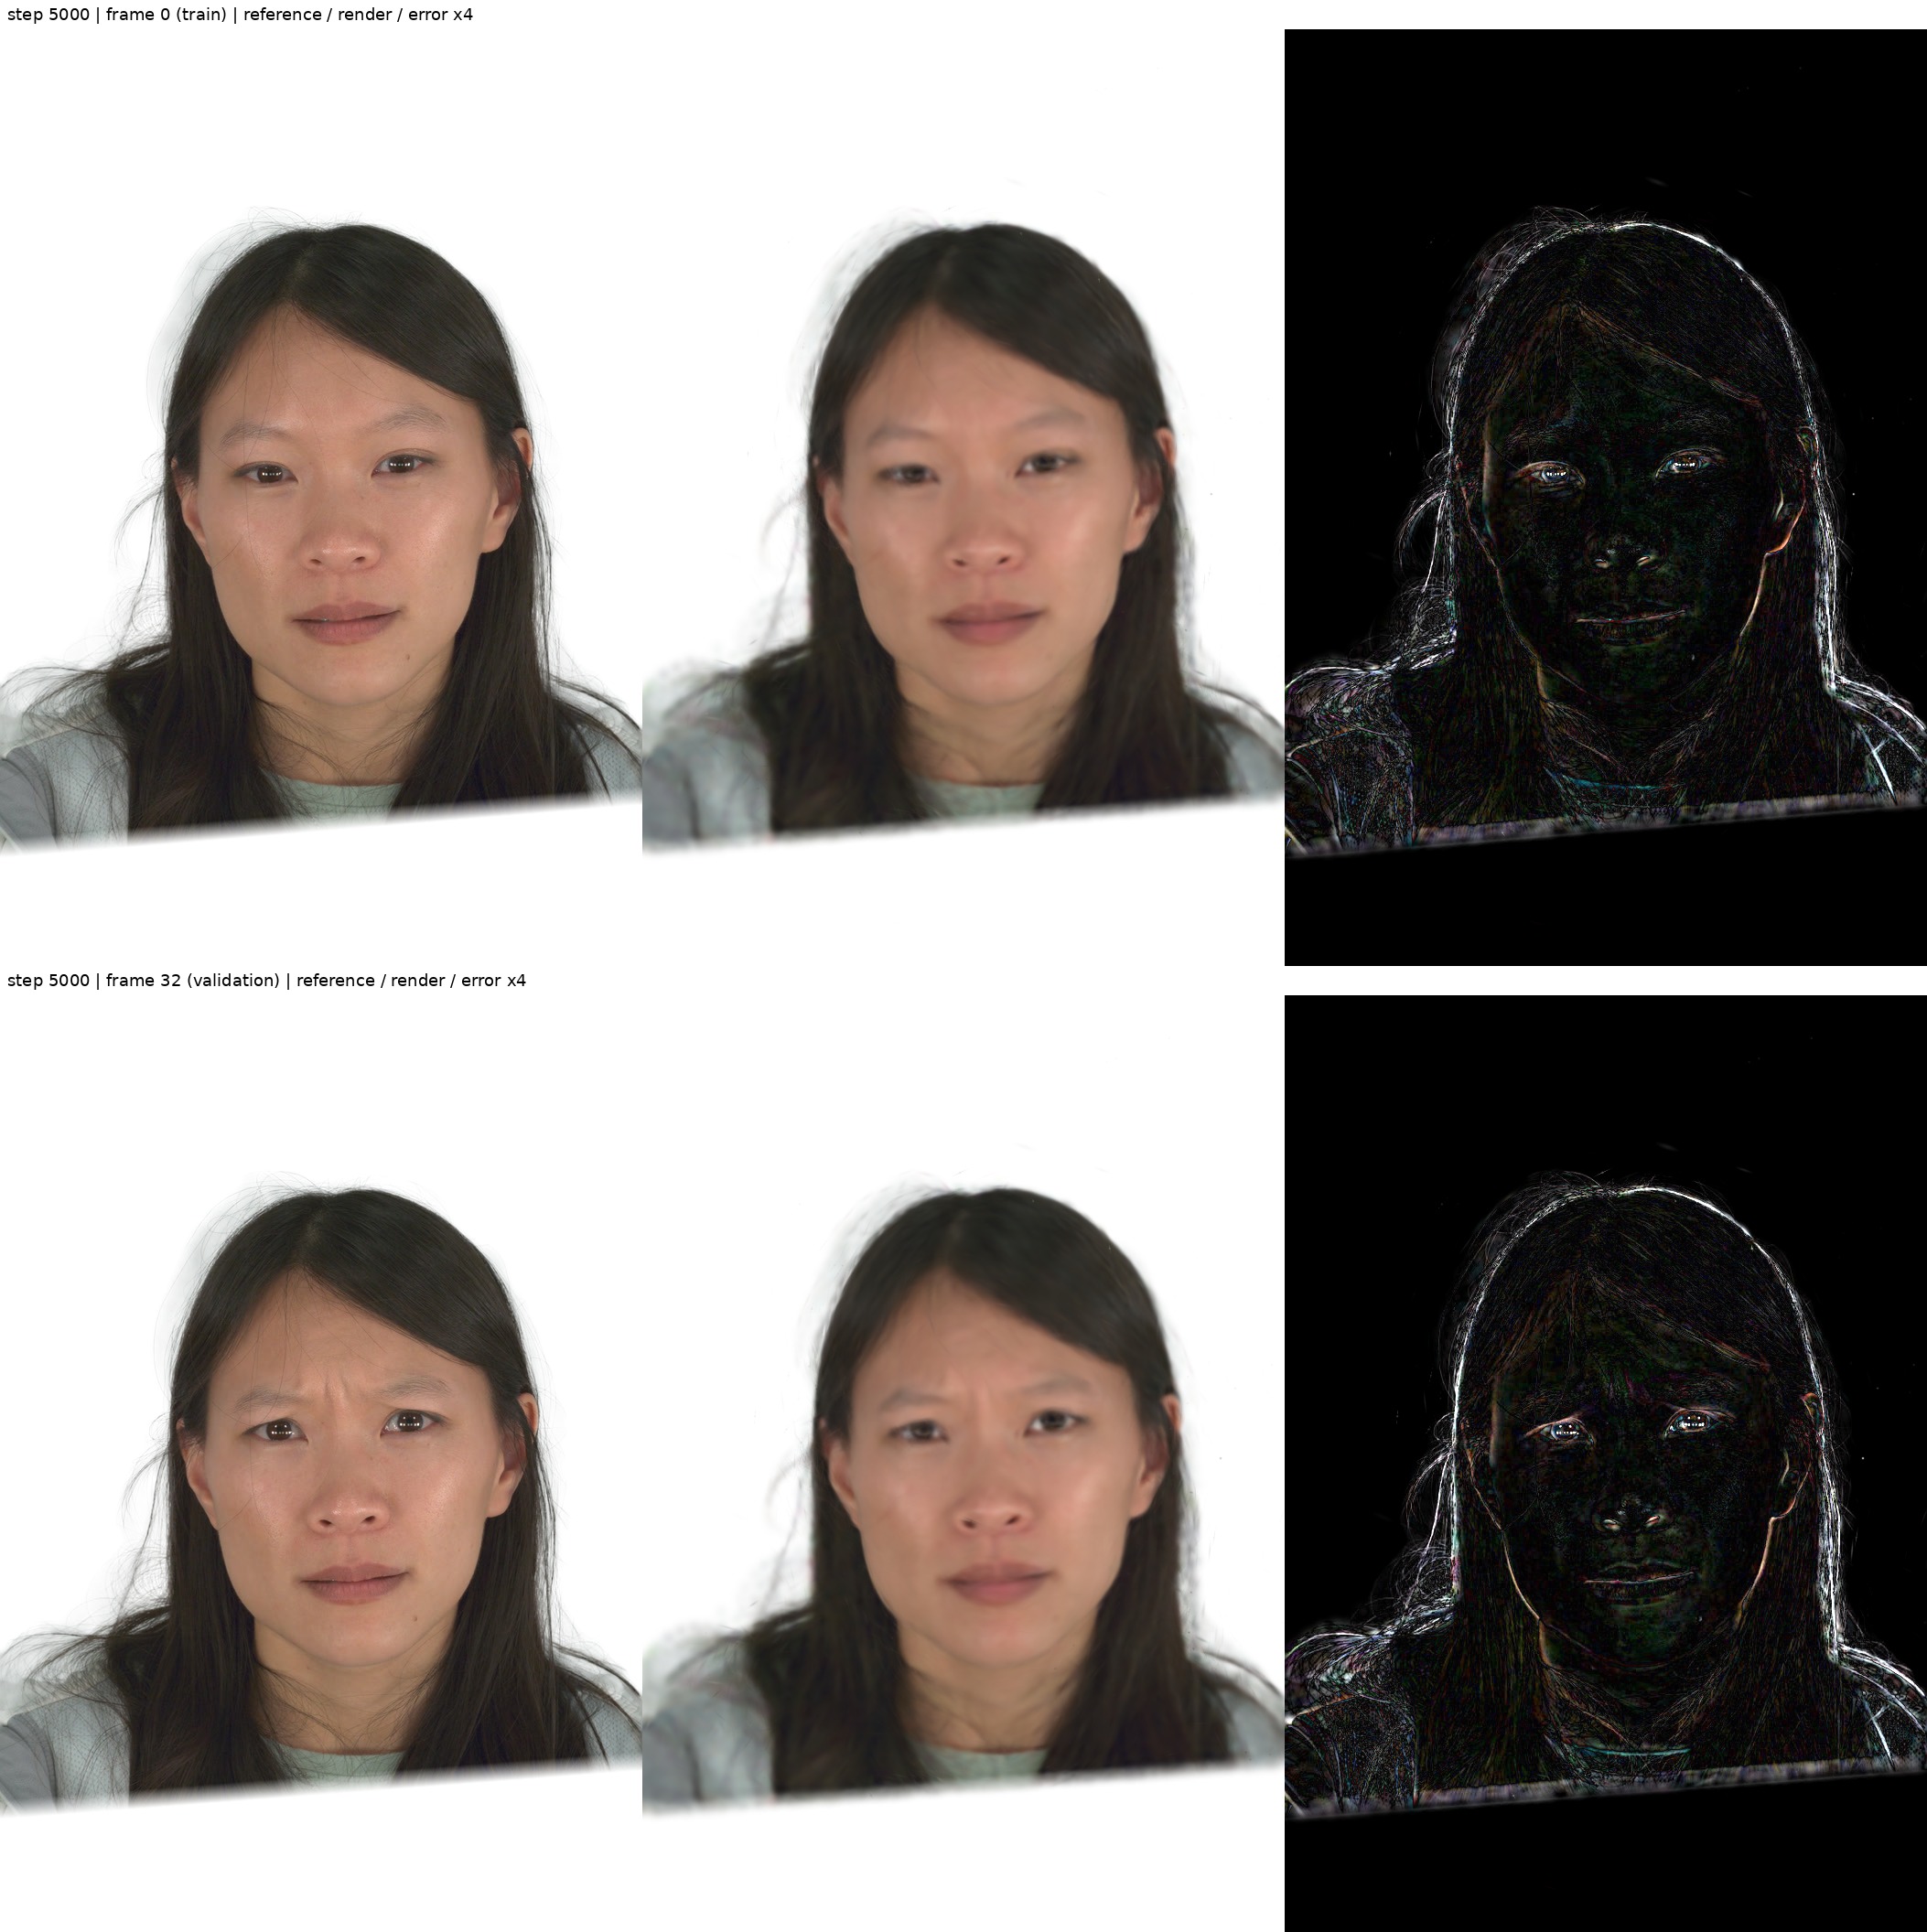
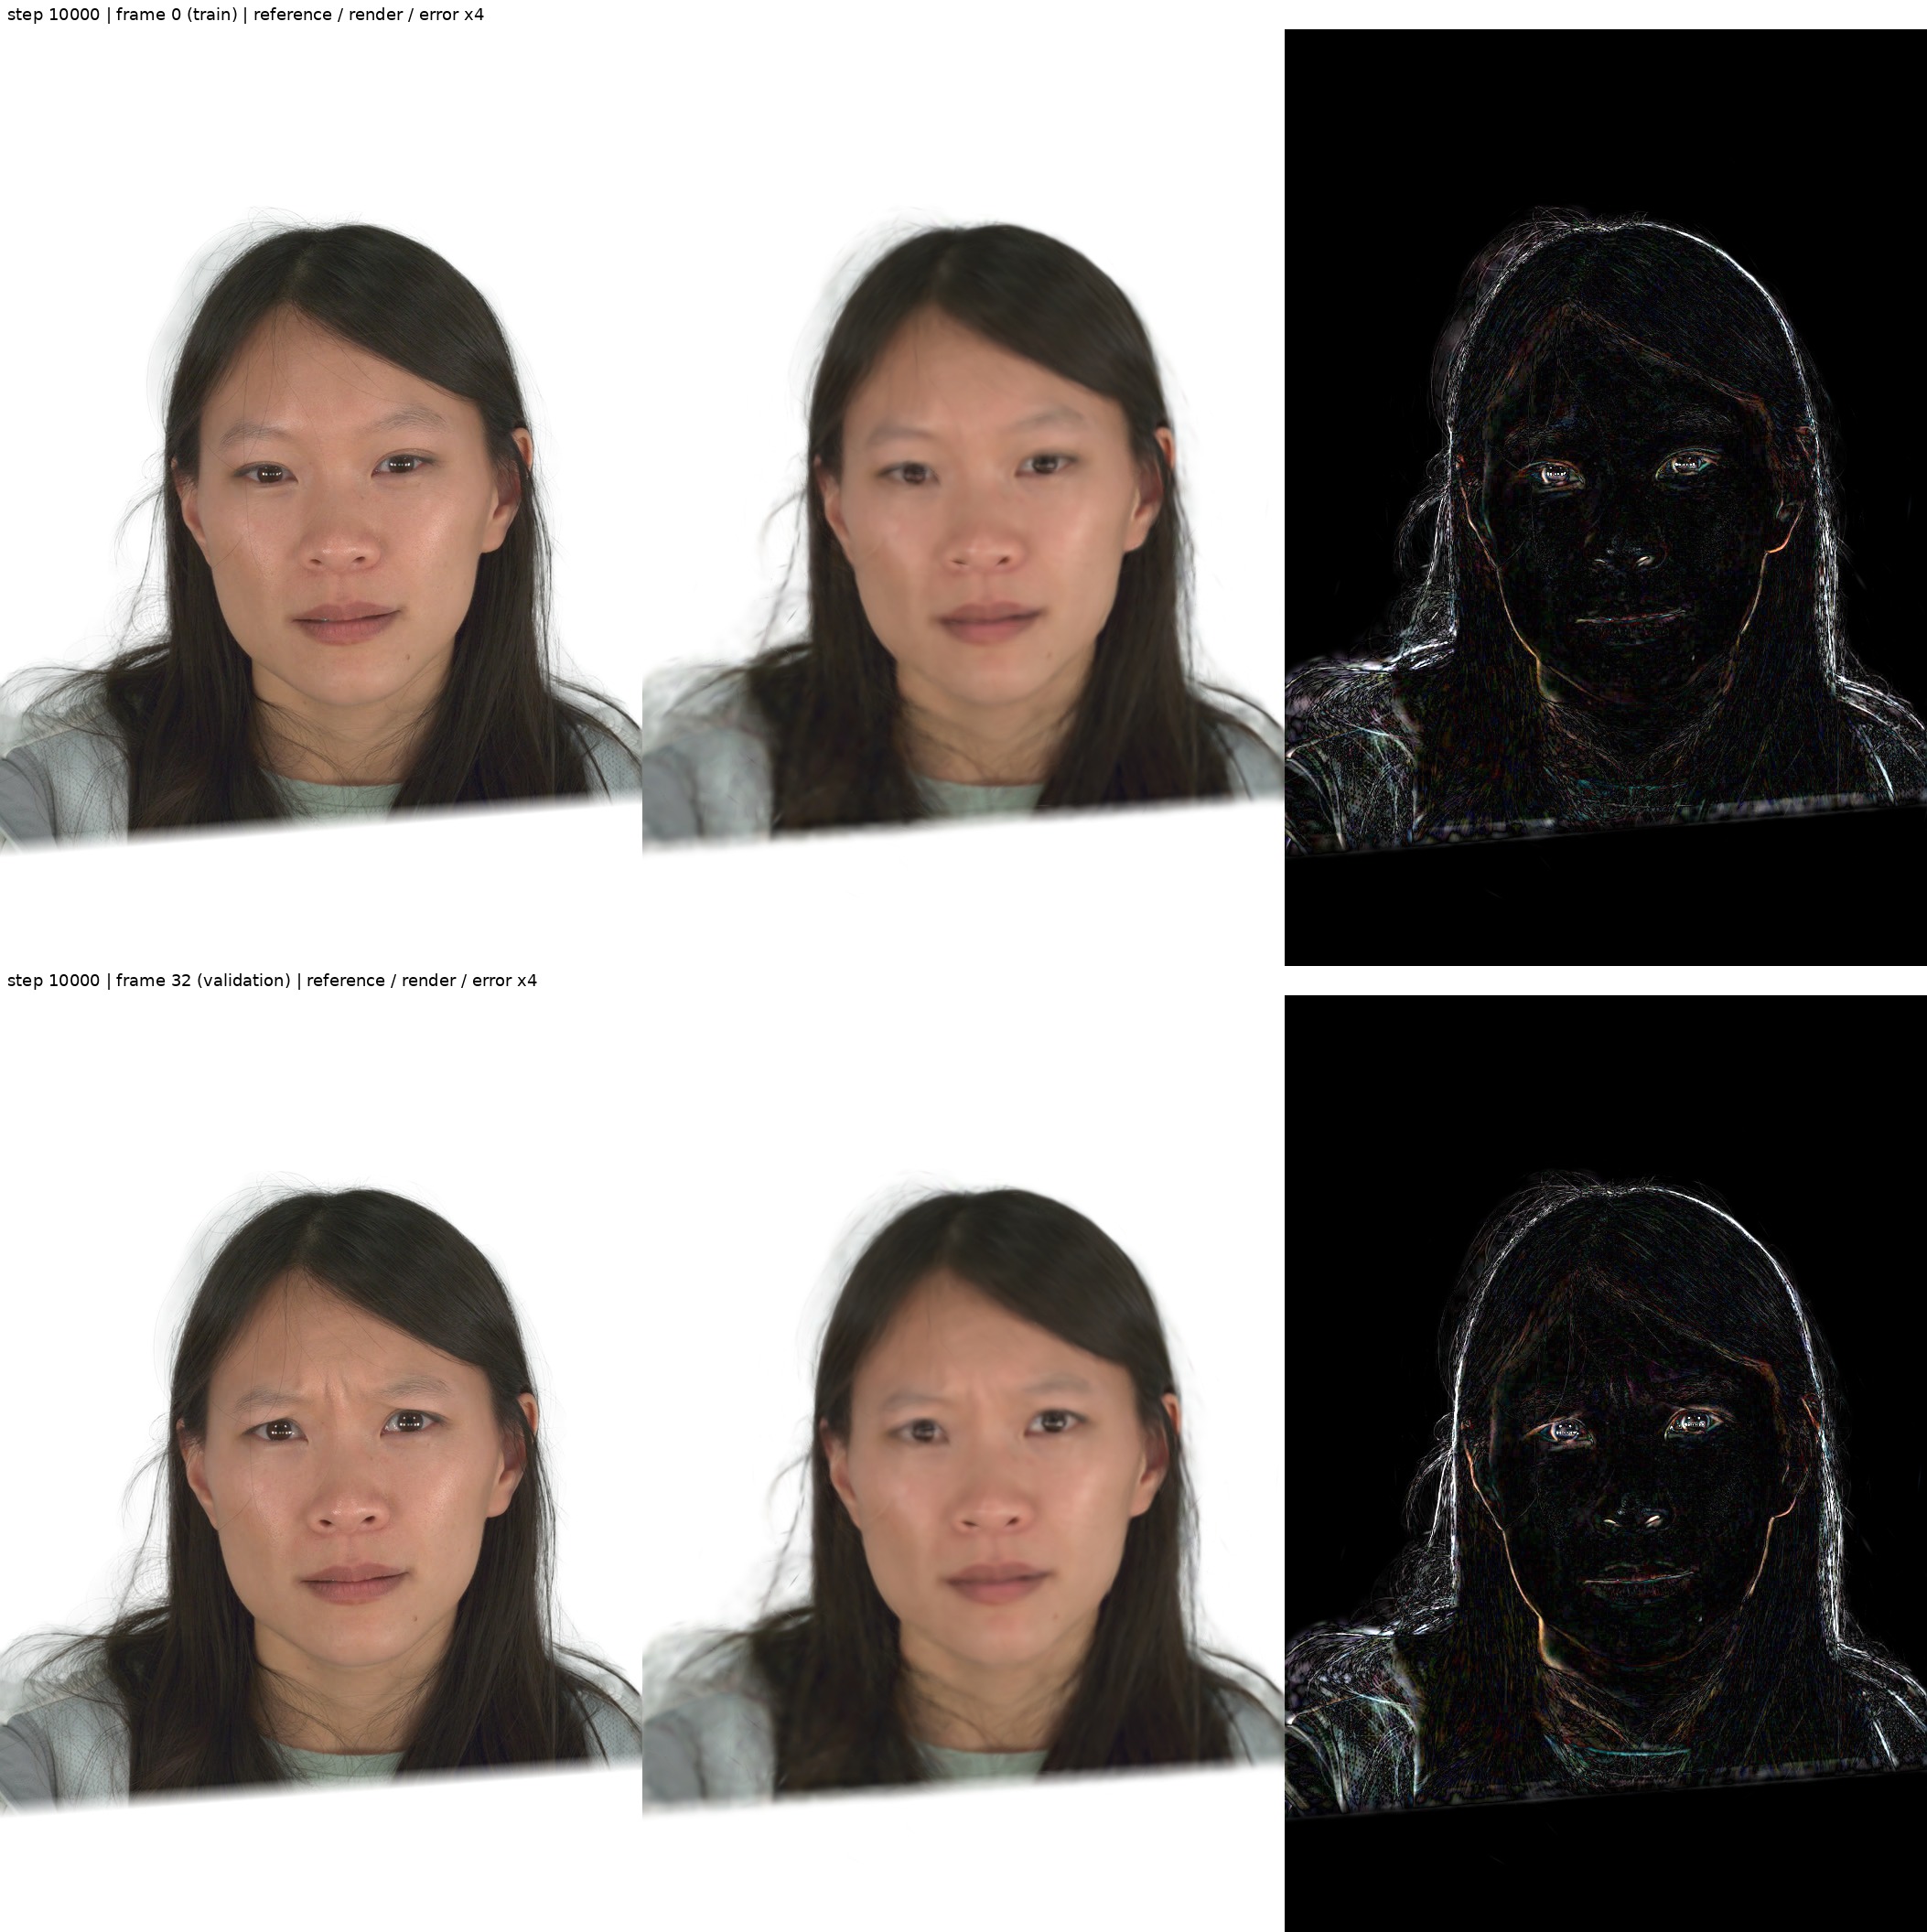
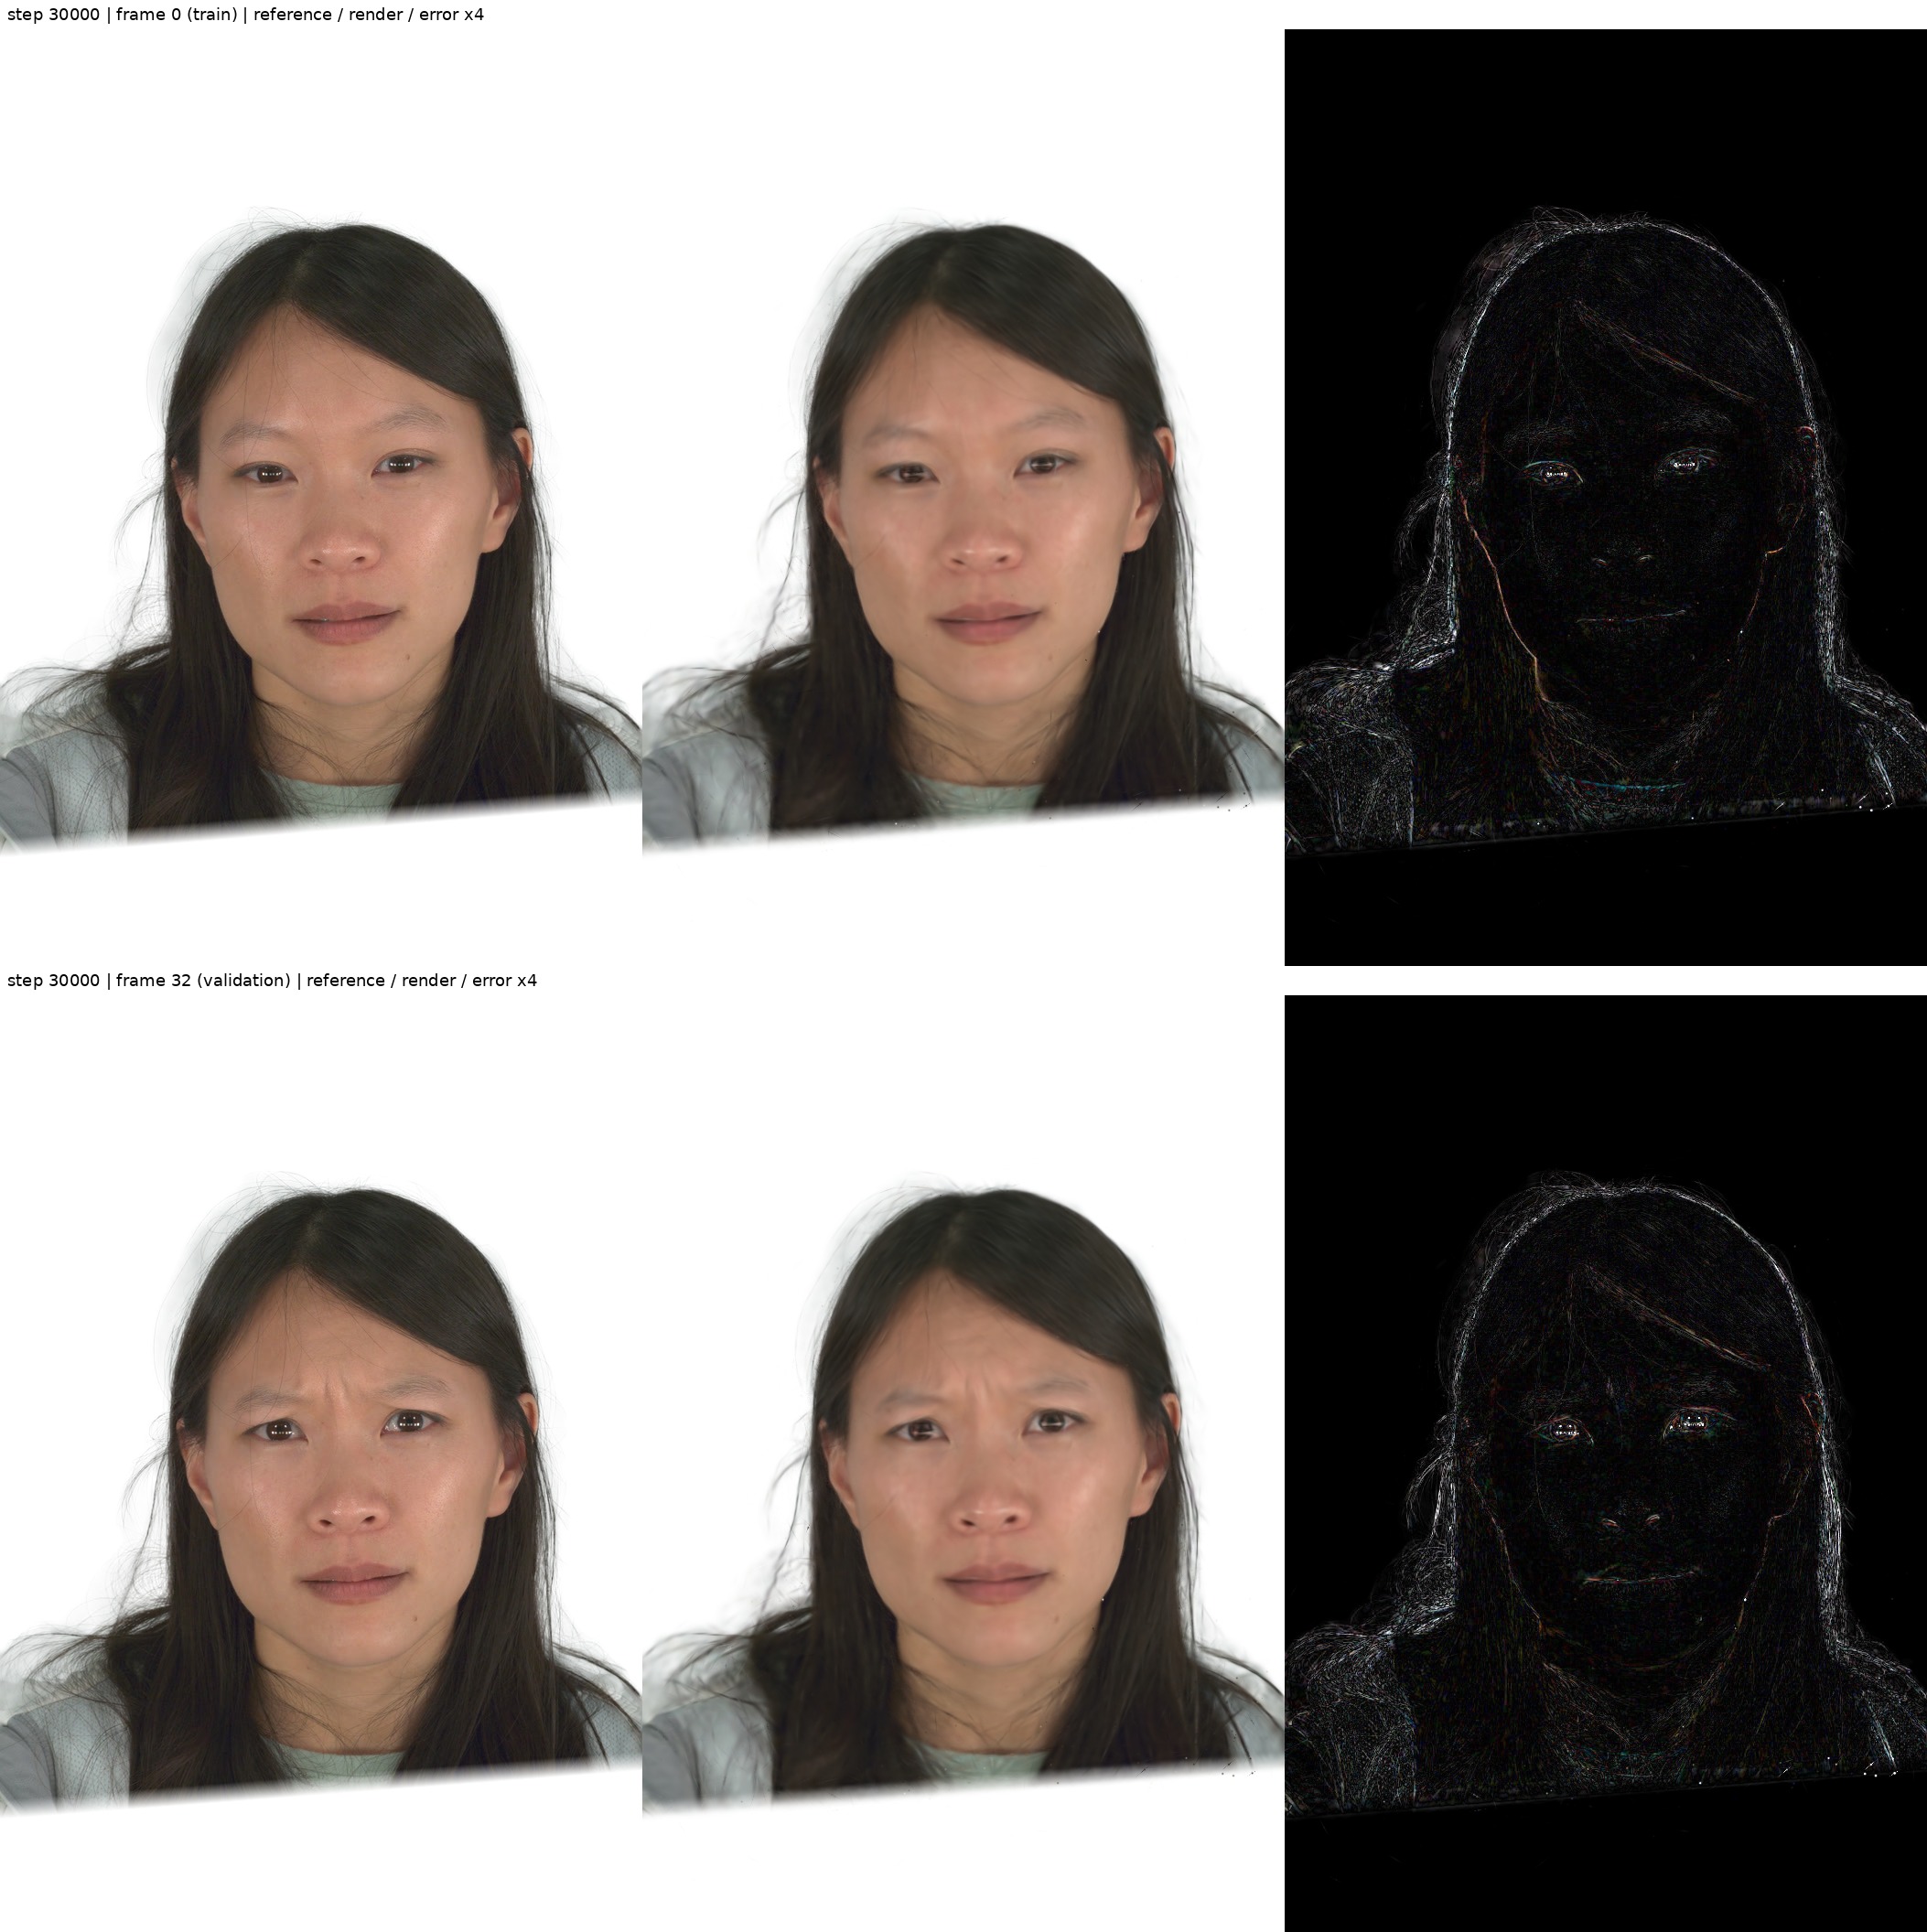
Full-Pipeline을 다시 한 번 정리해보자면
input UV + FLAME parameter each frame
→ Mesh2Gaussian (학습)
→ 2DGS Gaussian UV Map
→ FLAME 표면 배치 & 디코딩 (고정 알고리즘 계산)
→ 렌더링
→ 실제 Video frame과 비교 Loss
→ Backward (Mesh2Gaussian Update)
결국 해당 Full-Pipeline에서 학습이 되면서 Update가 되는 곳은 오직 Mesh2Gaussian Network의 weight뿐이다.
Mesh2Gaussian Network 안에서도
ExprEncoder → 입력 FLAME Parameter들을 embedding하는 encoder
SongUNet → 입력 UV와 embedding된 parameter들을 이용하여 16Ch 2D Gaussian UV feature map으로 Decoding하는 model.
geometry,appearance head → 16ch 2D Gaussian feature map을 13ch geometry, 3ch apperance Gaussian UV Map으로 각각 학습되는 network.
Validation 수치자체도 확인해보면 아래와 같이 꾸준히 잘 개선되는 것을 확인할 수 있다.
1000 : PSNR: 26.042 / SSIM: 0.8912 / LPIPS: 0.1585
2000 : PSNR: 27.462 / SSIM: 0.8980 / LPIPS: 0.1462
5000 : PSNR: 28.337 / SSIM: 0.9046 / LPIPS: 0.1184
10000 : PSNR: 29.346 / SSIM: 0.9098 / LPIPS: 0.1049
30000 : PSNR: 31.195 / SSIM: 0.9206 / LPIPS: 0.0803
5. Animation & Eval (9, 10)
직접적인 Comparison은 다음과 같다. (GT / Ours / Error map)
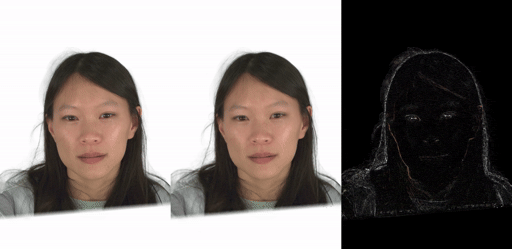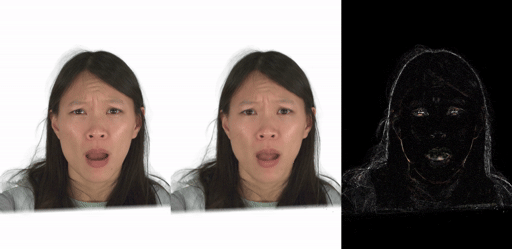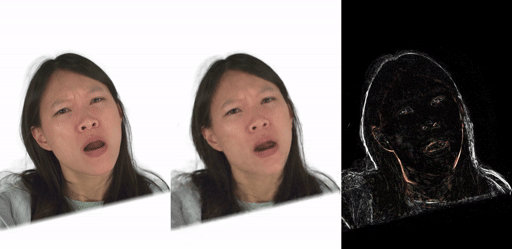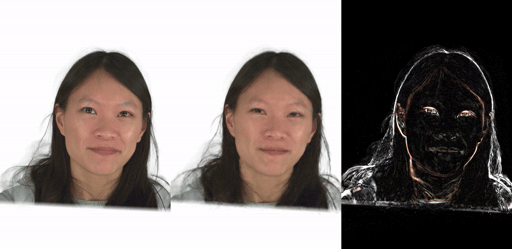
위 영상을 보면 알 수 있겠찌만 Personalization을 한다고 해도 아마 닫혀있는 부분이나 잘 보이지 않는 부분(입, 눈)쪽에서 Animation을 할 때 크게 에러가 있는 것을 확인할 수 있다. 이는 이 방법론만의 문제라고는 확인하기 힘들지만 Training View에서도 이러한 artifact가 일어나는건 아쉬운 수준인 것 같다.
아래는 최종 결과물들에 대한 다양한 render 결과물이다. rgb render를 비롯해서 normal, depth, alpah, gaussian uv map을 video로 출력한 결과이다.
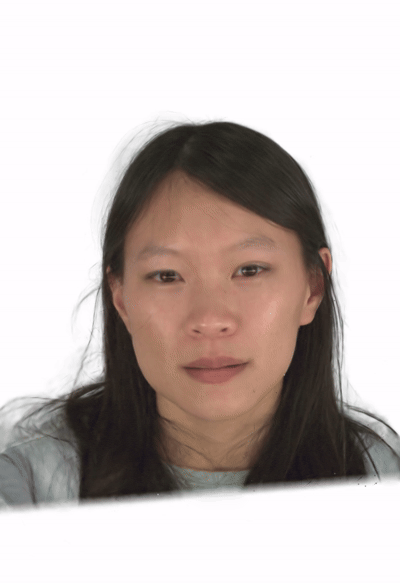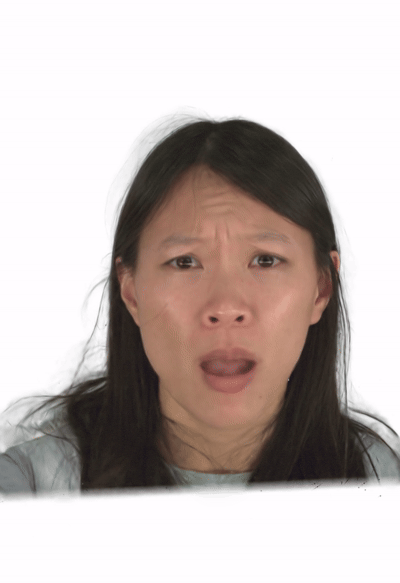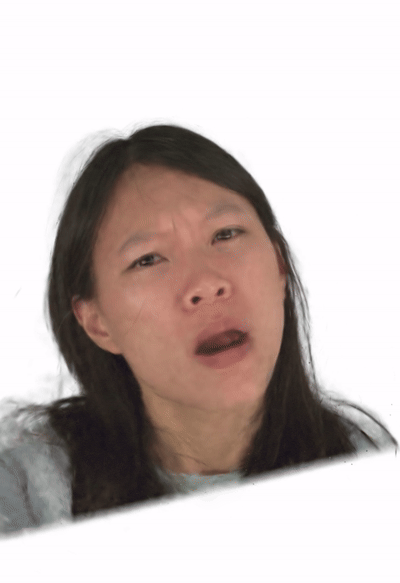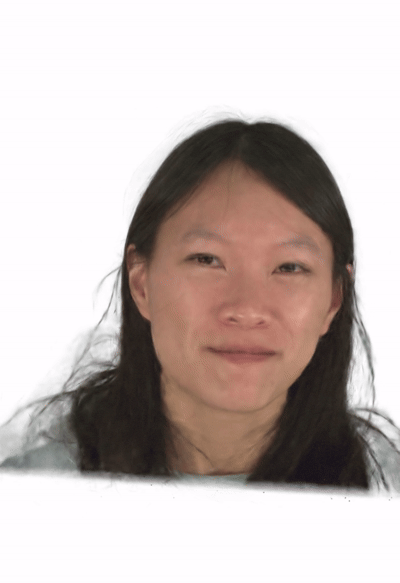
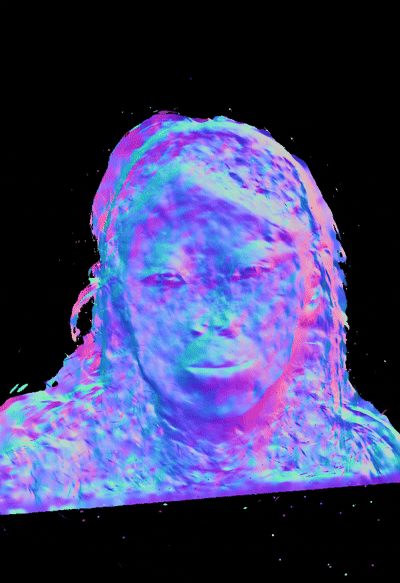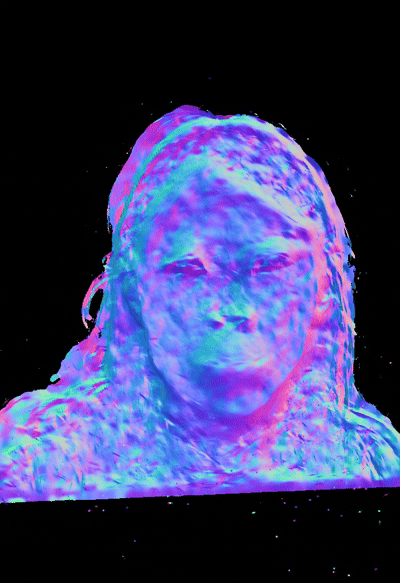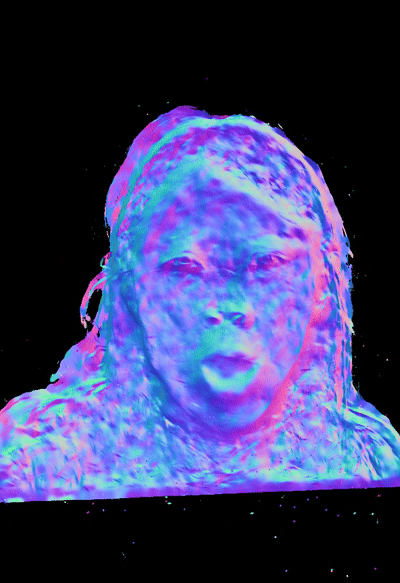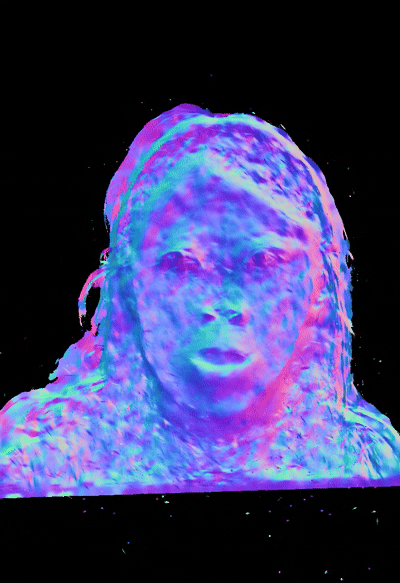
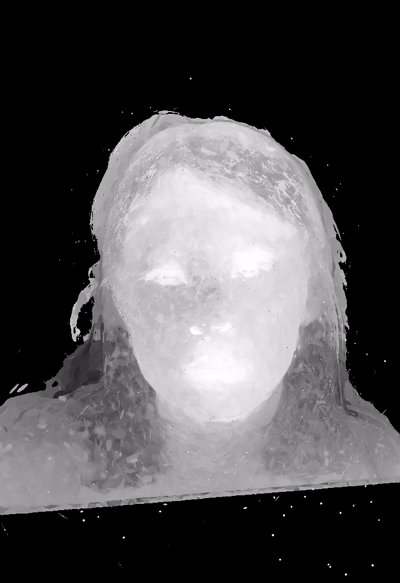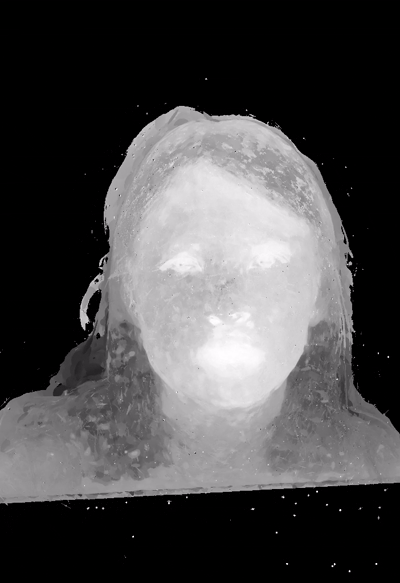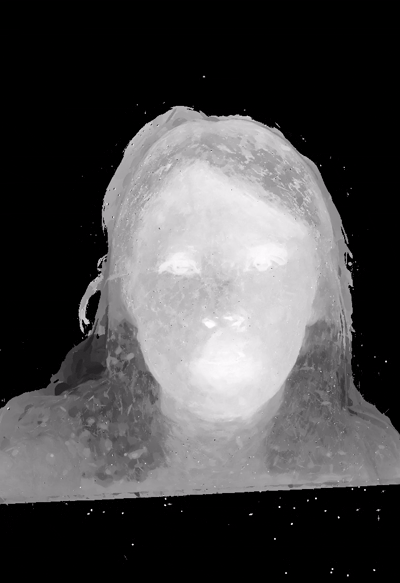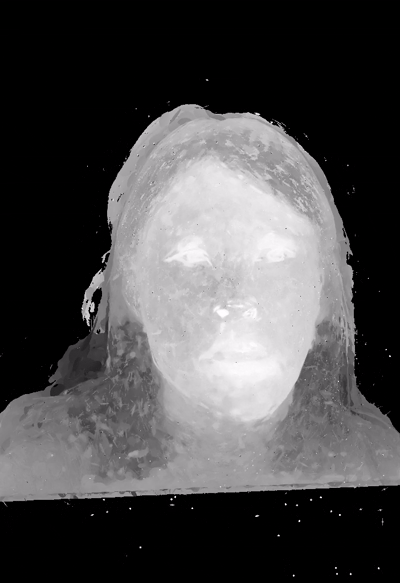
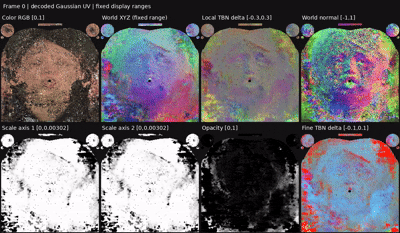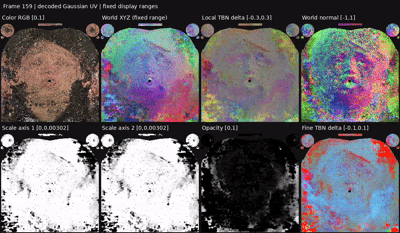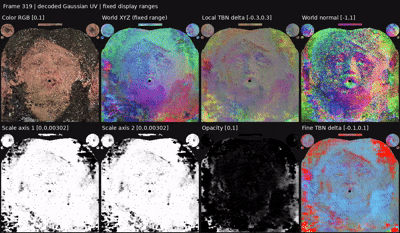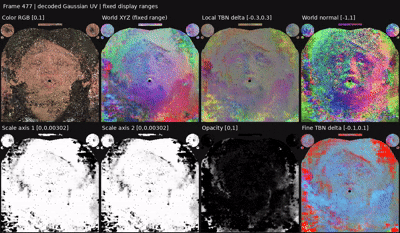
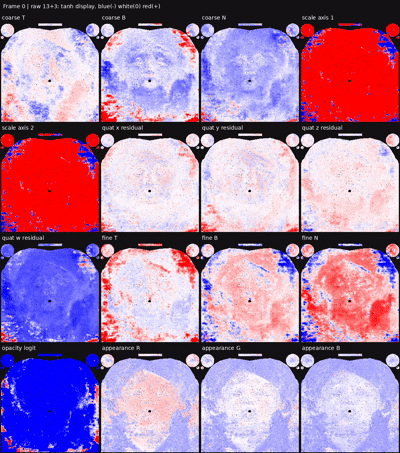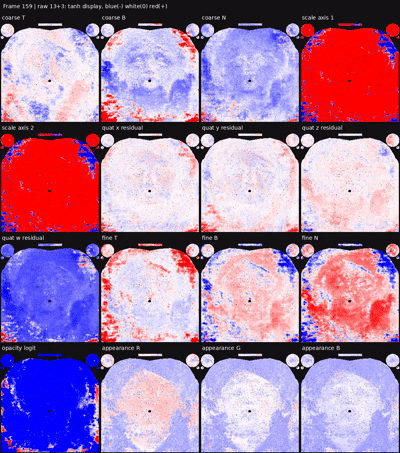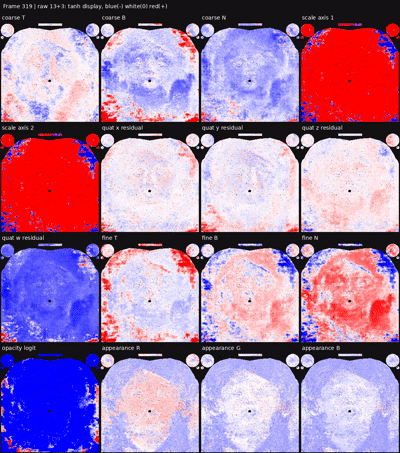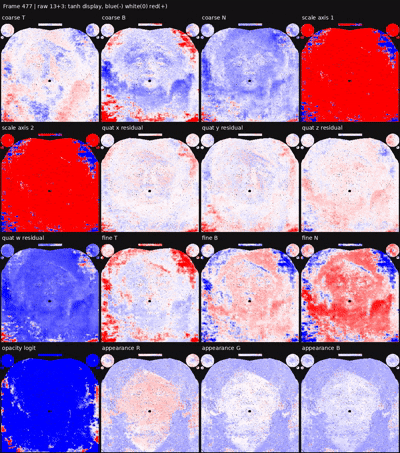
재미있는건 gaussian uv map은 대충 보면 변하는건가 싶겠지만 자세히 보면 조금씩 움찔거리면서 색이 변하는게 보이곤한다. Animation을 하면서 기존의 gaussian들의 색상이나 position값, scale, rotation이 움직이면서 변화하는 것을 2D UV Map으로 확인할 수 있었다.
정리하며
결국 우리가 여기서 확인하고자 하는 것은 Video data를 Mesh UV Map을 추출하면서 부터 2D Gaussian UV Map으로 변환하여 이를 실제 Avatar Rendering에 표현하는 것을 확인해보았다.
3D Prior가 기본적이라고 생각하였던 이 도메인에서 2D UV Prior를 이용한다는 부분이 굉장히 재밌는 부분이었고 이러한 부분의 도움을 받아 MUA같은 작업들을 진행해볼 수 있지 않을까도 싶다.